6. hodina – Řetězce
Skládání textu pomocí f-stringů, zarovnání a speciální znaky, metody řetězců, indexování a výřezy.
Výklad a cvičení
Výklad si můžeš přečíst přímo na webu. Příklady procházej po pořadí a kód si zkoušej ve VS Code.
Skládání textu pomocí f-stringů, zarovnání a speciální znaky, metody řetězců, indexování a výřezy.
Výklad si můžeš přečíst přímo na webu. Příklady procházej po pořadí a kód si zkoušej ve VS Code.
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Spusť soubor a porovnej výsledky.
Textu se v Pythonu odborně říká řetězec (anglicky string) – řetěz znaků navázaných za sebou. Pracuješ s ním od první lekce. Tohle už znáš:
print("Ahoj" + " " + "PyLadies!")   # spojení plusem    (lekce 1)
print("=" * 20)                     # opakování         (lekce 1)
print(len("Ahoj"))                  # délka – 4         (lekce 3)
print("o" in "Ahoj")                # hledání – True    (lekce 3)

for pismeno in "Ahoj":              # průchod po znacích    (lekce 3)
    print(pismeno)
Z lekce 1 taky víš, že input() vrací text a int() z něj udělá číslo. Opačný směr má na starosti funkce str():
vek = 30
print("Je mi " + str(vek) + " let")     # Je mi 30 let
Plus umí spojit jenom text s textem. Kdybys napsala "Je mi " + vek, tedy text plus číslo, Python by spadl na TypeError. Proto to str() – udělá z čísla 30 text "30" a ten už se spojit dá.
Čím víc kousků, tím hůř se taková věta píše i čte – uhlídat je potřeba každou mezeru a kolem každého čísla str():
jmeno = "Anna"
print("Ahoj " + jmeno + ", je ti " + str(vek) + " let.")Spusť soubor a porovnej výsledky.
jmeno = "Anna"
vek = 30
Před uvozovky napiš f a proměnnou dej do složených závorek:
print(f"Je mi {vek} let")       # Je mi 30 let
print(f"Ahoj {jmeno}")          # Ahoj Anna
Python si hodnotu ze závorek doplní do textu. Číslo si převede sám a mezery jsou tam, kde je napíšeš.
Závorek může být v jedné větě, kolik potřebuješ. Tohle je ta věta, na které minulý soubor skončil:
print(f"Ahoj {jmeno}, je ti {vek} let.") # Ahoj Anna, je ti 30 let.Žádné str(), žádné hlídání mezer kolem plusů.
Zpět na téma: Skládání textu · Další: Co může být ve složených závorkách
Spusť soubor a porovnej výsledky.
kniha = "Malý princ"
stran_celkem = 320
precteno = 184
Nejen proměnná. Do závorek jde i výpočet:
print(f"Zbývá {stran_celkem - precteno} stran.") # Zbývá 136 stran.Vestavěná funkce:
print(f"Název má {len(kniha)} znaků.") # Název má 10 znaků.Porovnání, které vrátí True nebo False:
print(f"Jsem za polovinou? {precteno > stran_celkem / 2}") # TrueI vlastní funkce z lekce 5:
def procenta(cast, celek):
    return cast / celek * 100

print(f"Přečteno: {procenta(precteno, stran_celkem)} %")
Zpět na téma: Skládání textu · Další: Zaokrouhlení ve f-stringu
Spusť soubor a podívej se na první řádek výpisu.
V minulém souboru vyšlo u přečtených stran 57.49999999999999 a nebyl to překlep. S desetinnými čísly počítá Python s drobnou nepřesností a na ceně je to vidět taky:
cena = 249
s_dph = cena * 1.21

print(f"Cena s DPH: {s_dph}")           # Cena s DPH: 301.28999999999996
Dvojtečka a .2f za výrazem říkají: zaokrouhli na dvě desetinná místa.
print(f"Cena s DPH: {s_dph:.2f}") # Cena s DPH: 301.29Zaokrouhlovat umí i funkce round(), kterou znáš z vestavěných funkcí. U částek, kterým druhé desetinné místo chybí, se obě cesty rozejdou:
zaloha = 200 * 1.21
print(round(zaloha, 2))                 # 242.0
print(f"{zaloha:.2f}") # 242.00Spusť soubor a sleduj, kde ve výpisu začínají čísla.
mesto = "Praha"
teplota = 23.4
Takhle teplota začíná hned za názvem, takže u každého města jinde:
print(f"{mesto} {teplota:.1f}") # Praha 23.4Za dvojtečku se vedle .1f dá napsat i číslo. To říká, kolik místa si hodnota zabere. Text se v tom místě zarovná doleva:
print(f"[{mesto:12}]") # [Praha ]a číslo doprava:
print(f"[{teplota:8.1f}]") # [ 23.4]Dvanáct míst na město a osm na teplotu udělá z výpisu tabulku:
def radek(nazev, stupne):
    print(f"{nazev:12}{stupne:8.1f}")

radek("Praha", 23.4)
radek("Brno", 8.1)
radek("Ostrava", -3.5)
Na zarovnaných číslech je minus hned vidět.
Směr se dá určit i ručně: > doprava, < doleva.
print(f"[{mesto:>12}]")             # [       Praha]
print(f"[{mesto:<12}]")             # [Praha       ]
Zpět na téma: Skládání textu · Další: Speciální znaky v textu
Spusť soubor a porovnej, co se vypsalo, s tím, co je v uvozovkách.
Zpětné lomítko a n (\n) uvnitř textu znamená nový řádek. Tenhle jeden print vypíše tři řádky:
print("Anna Nováková\nDlouhá 5\nPraha")Uvozovka text ukončuje. Když ji chceš mít uvnitř, označíš ji lomítkem:
print("Řekla \"ahoj\" a odešla.")Nebo použiješ druhý druh uvozovek, jednoduché:
print('Řekla "ahoj" a odešla.')Když má lomítko zůstat lomítkem, píše se dvakrát. Cesta k souboru:
print("C:\\Users\\Anna\\dokumenty")S jedním lomítkem by Python u "\U" hlásil chybu, protože by ho četl jako začátek speciálního znaku. Cesty k souborům budeš psát v lekci 13.
Delší text se píše mezi tři uvozovky a řádkuje se, jak potřebuješ. Tenhle zápis jsi viděla v lekci 5 u popisu funkce:
print("""Milá Anno,

kurz pokračuje v úterý od šesti.
Těšíme se!""")
I před tři uvozovky patří f, když chceš doplňovat hodnoty:
jmeno = "Anna Nováková"
den = "úterý"
hodina = 18
print(f"""Přihláška přijata

Jméno:  {jmeno}
Termín: {den} od {hodina} hodin""")
Zpět na téma: Skládání textu · Další: Cvičení: Skládání textu
Každé cvičení má vlastní soubor ve složce lekce06-retezce/01_skladani_textu/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Soubor: cviceni/01_vymyslena_veta.py
Zeptej se na podstatné jméno, sloveso a přídavné jméno. Všechna tři slova pak f-stringem dosaď do jedné věty. Čím nesmyslnější věta vyjde, tím líp. Třeba:
Dneska jsem viděla fialový rohlík, jak programuje.
podstatne = input("Podstatné jméno: ")
sloveso = input("Sloveso: ")
pridavne = input("Přídavné jméno: ")

print(f"Dneska jsem viděla {pridavne} {podstatne}, jak {sloveso}.")Soubor: cviceni/02_uctenka.py
Vypiš účtenku tak, aby ceny byly pod sebou: název zarovnaný doleva na dvanáct míst, cenu doprava na osm míst se dvěma desetinnými místy. Na konec přidej řádek se součtem.
Když je součet vyšší než 150 Kč, přidej ještě řádek se slevou deset procent a řádek s cenou po slevě.
polozka1 = "káva"
cena1 = 59
polozka2 = "dort"
cena2 = 84.5
polozka3 = "čaj"
cena3 = 45polozka1 = "káva"
cena1 = 59
polozka2 = "dort"
cena2 = 84.5
polozka3 = "čaj"
cena3 = 45
def radek(nazev, castka):
print(f"{nazev:12}{castka:8.2f}")
radek(polozka1, cena1)
radek(polozka2, cena2)
radek(polozka3, cena3)
soucet = cena1 + cena2 + cena3
radek("součet", soucet)
if soucet > 150:
sleva = soucet * 0.1
radek("sleva", sleva)
radek("k platbě", soucet - sleva)Řádek se opakoval pořád stejně, tak si na něj jde napsat funkci z lekce 5 – a pak ji použít i na součet a slevu.
Soubor: cviceni/03_adresa.py
Jedním jediným printem vypiš adresu na tři řádky. Jméno, ulici a město ber z proměnných, řádky odděl pomocí \n.
jmeno = "Anna Nováková"
ulice = "Dlouhá 5"
mesto = "110 00 Praha"jmeno = "Anna Nováková"
ulice = "Dlouhá 5"
mesto = "110 00 Praha"
print(f"{jmeno}\n{ulice}\n{mesto}")Soubor: cviceni/04_citat.py
Vypiš větu, ve které je jedno slovo v uvozovkách. Třeba: Na tabuli stálo "Vítejte".
print("Na tabuli stálo \"Vítejte\".")Druhá možnost – text dát do jednoduchých uvozovek:
print('Na tabuli stálo "Vítejte".')Soubor: cviceni/05_pozvanka.py
Slož pozvánku na několik řádků a vypiš ji jedním printem. Použij tři uvozovky a f-string dohromady, hodnoty ber z proměnných. Má vyjít něco jako:
POZVÁNKA Anna Nováková
Kurz pokračuje ve čtvrtek od 18 hodin. Místo: Dlouhá 5
jmeno = "Anna Nováková"
den = "čtvrtek"
hodina = 18
misto = "Dlouhá 5"jmeno = "Anna Nováková"
den = "čtvrtek"
hodina = 18
misto = "Dlouhá 5"
print(f"""POZVÁNKA
{jmeno}
Kurz pokračuje ve {den} od {hodina} hodin.
Místo: {misto}""")Před tři uvozovky patří f stejně jako před jedny.
Soubor: cviceni/06_oprava_spojeni.py
Oprav kód a soubor spusť (Run).
Program spadne. Spusť ho, přečti si hlášku a oprav ho tak, aby věta vznikla f-stringem.
vek = 30
print("Je mi " + vek + " let")vek = 30
print(f"Je mi {vek} let")Plus umí spojit text s textem, číslo do něj nepatří – proto TypeError. F-string si číslo převede sám.
Zpět na téma: Skládání textu · Další: Bonusová cvičení: Skládání textu
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce06-retezce/01_skladani_textu/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Soubor: cviceni_bonusy/01_diplom.py
Vypiš diplom v rámečku z hvězdiček:
************************** * Anna Nováková * * Python pro začátečnice * **************************
Rámeček musí být přesně tak široký, jak je potřeba. Když jméno nebo název kurzu vyměníš za delší, musí se přizpůsobit sám – šířku tedy spočítej, nepiš ji natvrdo.
jmeno = "Anna Nováková"
kurz = "Python pro začátečnice"Nejdelší z obou řádků určuje šířku vnitřku. Ke každému řádku patří ještě hvězdička a mezera z obou stran, tedy čtyři znaky navíc.
vnitrek = max(len(jmeno), len(kurz))
sirka = vnitrek + 4

print("*" * sirka)
print(f"* {jmeno:{vnitrek}} *")
print(f"* {kurz:{vnitrek}} *")
print("*" * sirka)
Šířka se dá do složených závorek dosadit z proměnné – proto {jmeno:{vnitrek}}.
Bez toho zápisu to jde taky, jen delším plusem:
print("* " + jmeno + " " * (vnitrek - len(jmeno)) + " *")Soubor: cviceni_bonusy/02_nasobilka.py
V lekci 3 jsi vnořenými cykly vypsala násobilkovou tabulku. Sloupce se v ní rozjely, protože dvojciferná čísla jsou širší:
1 2 3 4
2 4 6 8
3 6 9 12
4 8 12 16
Napiš ji znovu tak, aby čísla byla pod sebou. Tabulku rovnou zvětši na 10x10, ať je rozdíl pořádně vidět.
Vnořené cykly i print s end znáš z lekce 3. Nové je jen to, kolik místa každému číslu dáš.
for radek in range(1, 11):
    for sloupec in range(1, 11):
        print(f"{radek * sloupec:4}", end="")
    print()
Každé číslo dostane čtyři místa a zarovná se doprava, takže jednotky skončí pod jednotkami. Největší číslo v tabulce je 100 a na to stačí tři místa – čtvrté dělá mezeru mezi sloupci.
V lekci 3 bylo v printu end=" ", tedy mezera. Tady je end="" prázdné, protože mezeru už obstarává ta šířka.
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Spusť soubor a porovnej výsledky.
Funkce, které znáš, pracují s textem zvenčí – len() si ho vezme a změří:
print(len("pyladies")) # 8Řetězec umí věci i sám o sobě. Zapisuje se to tečkou:
jmeno = "pyladies"
print(jmeno.upper())        # PYLADIES
Čte se to takhle: jmeno hodnota, na které metodu voláme . tečka – „na téhle hodnotě" upper() metoda, tedy funkce, která k řetězci patří
Kulaté závorky znamenají „zavolej to" – stejně jako u len() nebo u tvých funkcí z lekce 5. Bez nich se metoda nezavolá a Python jenom oznámí, že nějaká taková metoda existuje:
print(jmeno.upper) # <built-in method upper of str object at ...>Takový výpis skoro vždycky znamená, že někde chybí závorky.
Metodu jde zavolat i rovnou na textu v uvozovkách:
print("pyladies".upper()) # PYLADIESA její výsledek se dá dosadit do f-stringu:
print(f"Vítej, {jmeno.upper()}!") # Vítej, PYLADIES!Zpět na téma: Metody řetězců · Další: Metoda vrací nový řetězec
Spusť soubor a sleduj, co se vypíše.
slovo = "pyladies"Zavoláme metodu a s výsledkem nic neděláme:
slovo.upper()
print(slovo)            # pyladies
Řádek se slovo.upper() proběhl. Velká písmena nikde nejsou, protože metoda výsledek vrátila a nikdo si ho nevzal. Je to stejná situace jako v lekci 5, kde funkce s return nic nevypsala, dokud sis návratovou hodnotu neuložila nebo nevytiskla.
print(slovo.upper())    # PYLADIES

velke = slovo.upper()
print(velke)            # PYLADIES
Původní řetězec zůstal, jak byl:
print(slovo) # pyladiesKdyž chceš mít v proměnné upravený text, přepíšeš ji výsledkem:
slovo = slovo.upper()
print(slovo)            # PYLADIES
Zpět na téma: Metody řetězců · Další: Užitečné metody řetězců
Spusť soubor a porovnej výsledky.
veta = "Ahoj PyLadies!"

print(veta.upper())                      # AHOJ PYLADIES!
print(veta.lower())                      # ahoj pyladies!
print(veta.count("a"))                   # 1
print(veta.replace("Ahoj", "Nazdar"))    # Nazdar PyLadies!
count("a") našlo jedno "a" – to v PyLadies. Velké "A" ze slova Ahoj je pro Python jiný znak.
print("anna nováková".title()) # Anna NovákováMetoda strip() odstraní mezery na krajích. Ve výpisu nejsou mezery vidět, hranaté závorky je ukážou:
odpoved = "  ano  "
print(f"[{odpoved}]")                    # [  ano  ]
print(f"[{odpoved.strip()}]")            # [ano]
Metod je mnohem víc. Ve VS Code napiš tečku za řetězec nebo za proměnnou a editor ti nabídne seznam. Pamatovat si je nemusíš – ty nejpoužívanější jsou i v taháku k téhle lekci.
Spusť soubor a zkus různé odpovědi: ano, ANO, nebo ano s mezerou.
V lekci 2 jsi odpověď porovnávala přímo:
if odpoved == "ano":Taková podmínka projde jen u přesně napsaného "ano". "ANO" ani " ano " už neprojdou, i když uživatelka myslela to samé.
odpoved = input("Chceš pokračovat? (ano/ne) ")Nejdřív po krocích, tak jak bys to napsala dneska:
bez_mezer = odpoved.strip()         # zmizí mezery na krajích
upravena = bez_mezer.lower()        # vzniknou malá písmena

print(f"[{upravena}]")

if upravena == "ano":
    print("Pokračujeme.")
else:
    print("Končíme.")
Protože strip() vrací řetězec, dá se lower() zavolat rovnou na jeho výsledku a obě metody napsat na jeden řádek. Vyhodnocuje se to zleva doprava, takže vyjde to samé:
zkracene = odpoved.strip().lower()

print(f"[{zkracene}]")
Takhle zkráceně se to píše nejčastěji.
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
Metoda isdigit() odpoví, jestli jsou v textu jenom číslice:
print("42".isdigit())       # True
print("ahoj".isdigit())     # False
print("4.2".isdigit())      # False – tečka není číslice
Z input() chodí vždycky text. Než ho pustíš do int(), vyplatí se zeptat, jestli je co převádět:
def za_rok(vstup):
    if vstup.isdigit():
        print(f"Za rok ti bude {int(vstup) + 1}")
    else:
        print("To není číslo.")

za_rok("30")        # Za rok ti bude 31
za_rok("třicet")    # To není číslo.
za_rok("")          # To není číslo.
Bez té kontroly program na stejné hodnotě spadne na ValueError:
print(int("třicet"))Zpět na téma: Metody řetězců · Další: Cvičení: Metody řetězců
Každé cvičení má vlastní soubor ve složce lekce06-retezce/02_metody_retezcu/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Soubor: cviceni/01_rozeber_slovo.py
Zeptej se na slovo a vypiš o něm čtyři řádky:
slovo velkými písmeny,
slovo malými písmeny,
kolik má znaků,
kolikrát je v něm písmeno "a".
Délku umí len() z lekce 3, zbytek jsou metody z výkladu.
slovo = input("Napiš slovo: ")
pocet_a = slovo.count("a")

print(f"Velkými:  {slovo.upper()}")
print(f"Malými:   {slovo.lower()}")
print(f"Znaků:    {len(slovo)}")
print(f"Písmen a: {pocet_a}")
count("a") nepočítá velké "A". Kdybys chtěla obojí, převeď slovo nejdřív na malá písmena: slovo.lower().count("a")
Soubor: cviceni/02_prekladac_frazi.py
Věta z firemní prezentace je plná frází. Vyměň je za srozumitelná slova a výsledek vypiš:
proaktivně -> včas implementovat -> zařídit synergie -> spolupráci
Výměny dělej po krocích, ať se řádky dají přečíst.
veta = "Musíme proaktivně implementovat synergie napříč týmy."veta = "Musíme proaktivně implementovat synergie napříč týmy."
srozumitelne = veta.replace("proaktivně", "včas")
srozumitelne = srozumitelne.replace("implementovat", "zařídit")
srozumitelne = srozumitelne.replace("synergie", "spolupráci")
print(srozumitelne) # Musíme včas zařídit spolupráci napříč týmy.Každý replace() vrací nový řetězec, takže další se volá rovnou na něm. Zřetězit se dají i za sebe na jeden řádek, u tří výměn by ale byl dlouhý přes celou obrazovku.
Soubor: cviceni/03_velikost_tricka.py
Ptej se na velikost trička, dokud uživatelka nenapíše S, M nebo L. Na nic jiného se nespokoj a zeptej se znovu. Velikost písmen ani mezery navíc ať nevadí – "s" i " M " mají projít. Nakonec vypiš objednanou velikost velkým písmenem.
Cyklus while True a break znáš z lekce 4.
while True:
    velikost = input("Jakou velikost? (S/M/L) ").strip().upper()
    if velikost == "S" or velikost == "M" or velikost == "L":
        break
    print("Vyber S, M nebo L.")

print(f"Objednáno: tričko velikosti {velikost}.")
Tady se hodí upper(), protože výsledek chceme velkým písmenem. Bez strip() a upper() by cyklus u " m " nikdy neskončil.
Soubor: cviceni/04_tvar_pinu.py
Zeptej se na PIN a zkontroluj, jestli má správný tvar: přesně čtyři znaky a všechny číslice. Vypiš, jestli je v pořádku. Mezery navíc ať nevadí.
V lekci 5 jsi PINu dávala tři pokusy na uhodnutí. Tady jde o to, jestli vůbec vypadá jako PIN.
pin = input("Zadej PIN: ").strip()

if pin.isdigit() and len(pin) == 4:
    print("PIN má správný tvar.")
else:
    print("PIN musí být přesně čtyři číslice.")
Samotné isdigit() by pustilo i "12" nebo "123456", samotné len() zase "ab12". Teprve obě podmínky dohromady dávají tvar PINu.
Soubor: cviceni/05_oprava_metody.py
Oprav kód a soubor spusť (Run).
Program má vypsat jméno velkými písmeny. Vypisuje ho malými. Najdi chybu a oprav ji. Zbytek nech tak, jak je.
jmeno = "pyladies"
jmeno.upper()
print(jmeno)jmeno = "pyladies"
jmeno = jmeno.upper()
print(jmeno)Metoda upper() původní řetězec nemění, vrací nový. Aby změna zůstala, je potřeba si výsledek uložit. Nebo ho vypsat hned: print(jmeno.upper())
Zpět na téma: Metody řetězců · Další: Bonusová cvičení: Metody řetězců
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce06-retezce/02_metody_retezcu/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Soubor: cviceni_bonusy/01_uklid_jmen.py
Tři jména přišla z formuláře rozbitá – mezery na krajích a náhodná velikost písmen. U každého vypiš jeden řádek: uklizené jméno a k němu přihlašovací jméno, které z něj vyrobíš. To je celé malými písmeny a místo mezery má tečku.
Pro " anna NOVÁKOVÁ " má vyjít: Anna Nováková -> anna.nováková
jmeno1 = "  anna NOVÁKOVÁ  "
jmeno2 = "PETRA svobodová"
jmeno3 = " tereza Dvořáková "jmeno1 = " anna NOVÁKOVÁ "
jmeno2 = "PETRA svobodová"
jmeno3 = " tereza Dvořáková "
def uklid(jmeno):
cele = jmeno.strip().title()
prihlasovaci = cele.lower().replace(" ", ".")
print(f"{cele} -> {prihlasovaci}")
uklid(jmeno1)
uklid(jmeno2)
uklid(jmeno3)title() udělá velké první písmeno každého slova a zbytek malý, takže srovná i NOVÁKOVÁ na Nováková.
replace(" ", ".") vymění každou mezeru za tečku. Protože jméno prošlo přes strip(), žádná mezera navíc na kraji nezůstala – jinak by z ní vznikla tečka.
Soubor: cviceni_bonusy/02_kontrola_hesla.py
Zeptej se na heslo a zkontroluj tři věci: je aspoň osm znaků dlouhé, je v něm aspoň jedna číslice a je v něm aspoň jedno velké písmeno.
Ke každé podmínce vypiš, jestli prošla. Na konec vypiš, jestli je heslo přijaté – to je, jen když prošly všechny tři.
Na číslici se zeptáš průchodem přes znaky: cyklus for z lekce 3 a isdigit() na každý znak. Na velké písmeno stačí porovnat heslo se sebou samým po lower(). Jde to ale i cyklem jako u číslice – každého znaku se tam zeptáš metodou isupper().
heslo = input("Zadej heslo: ")

dost_dlouhe = len(heslo) >= 8
lower() vrací nový řetězec, původní heslo nemění. Když se ty dva od sebe liší, muselo v hesle být velké písmeno – jinak by lower() vrátil přesně to samé.
ma_velke = heslo != heslo.lower()isdigit() na celém hesle by se ptalo, jestli jsou číslice všechny znaky. Tady potřebuješ vědět, jestli je číslice aspoň jedna – proto cyklus. Break ho ukončí, jakmile je jasno.
ma_cislici = False
for znak in heslo:
    if znak.isdigit():
        ma_cislici = True
        break

print(f"Aspoň osm znaků:  {dost_dlouhe}")
print(f"Obsahuje číslici: {ma_cislici}")
print(f"Velké písmeno:    {ma_velke}")

if dost_dlouhe and ma_cislici and ma_velke:
    print("Heslo přijato.")
else:
    print("Heslo nevyhovuje.")
Velké písmeno jde hledat i cyklem, úplně stejně jako číslici – jen se každého znaku ptáš metodou isupper(). Je to delší, zato je na první pohled vidět, co se hledá:
ma_velke_cyklem = False
for znak in heslo:
    if znak.isupper():
        ma_velke_cyklem = True
        break

print(f"Velké písmeno (cyklem): {ma_velke_cyklem}")
Obě řešení jsou správně.
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
slovo = "PyLadies"Cyklus for z lekce 3 ti podal znaky po jednom, od začátku do konce. Když chceš jenom jeden konkrétní, sáhneš si na něj rovnou. Každý znak má svoje pořadové číslo, kterému se říká index. Počítá se od nuly, takže první písmeno má index 0:
P y L a d i e s
╭───┬───┬───┬───┬───┬───┬───┬───╮
│ 0 │ 1 │ 2 │ 3 │ 4 │ 5 │ 6 │ 7 │   index
│-8 │-7 │-6 │-5 │-4 │-3 │-2 │-1 │   index od konce
╰───┴───┴───┴───┴───┴───┴───┴───╯
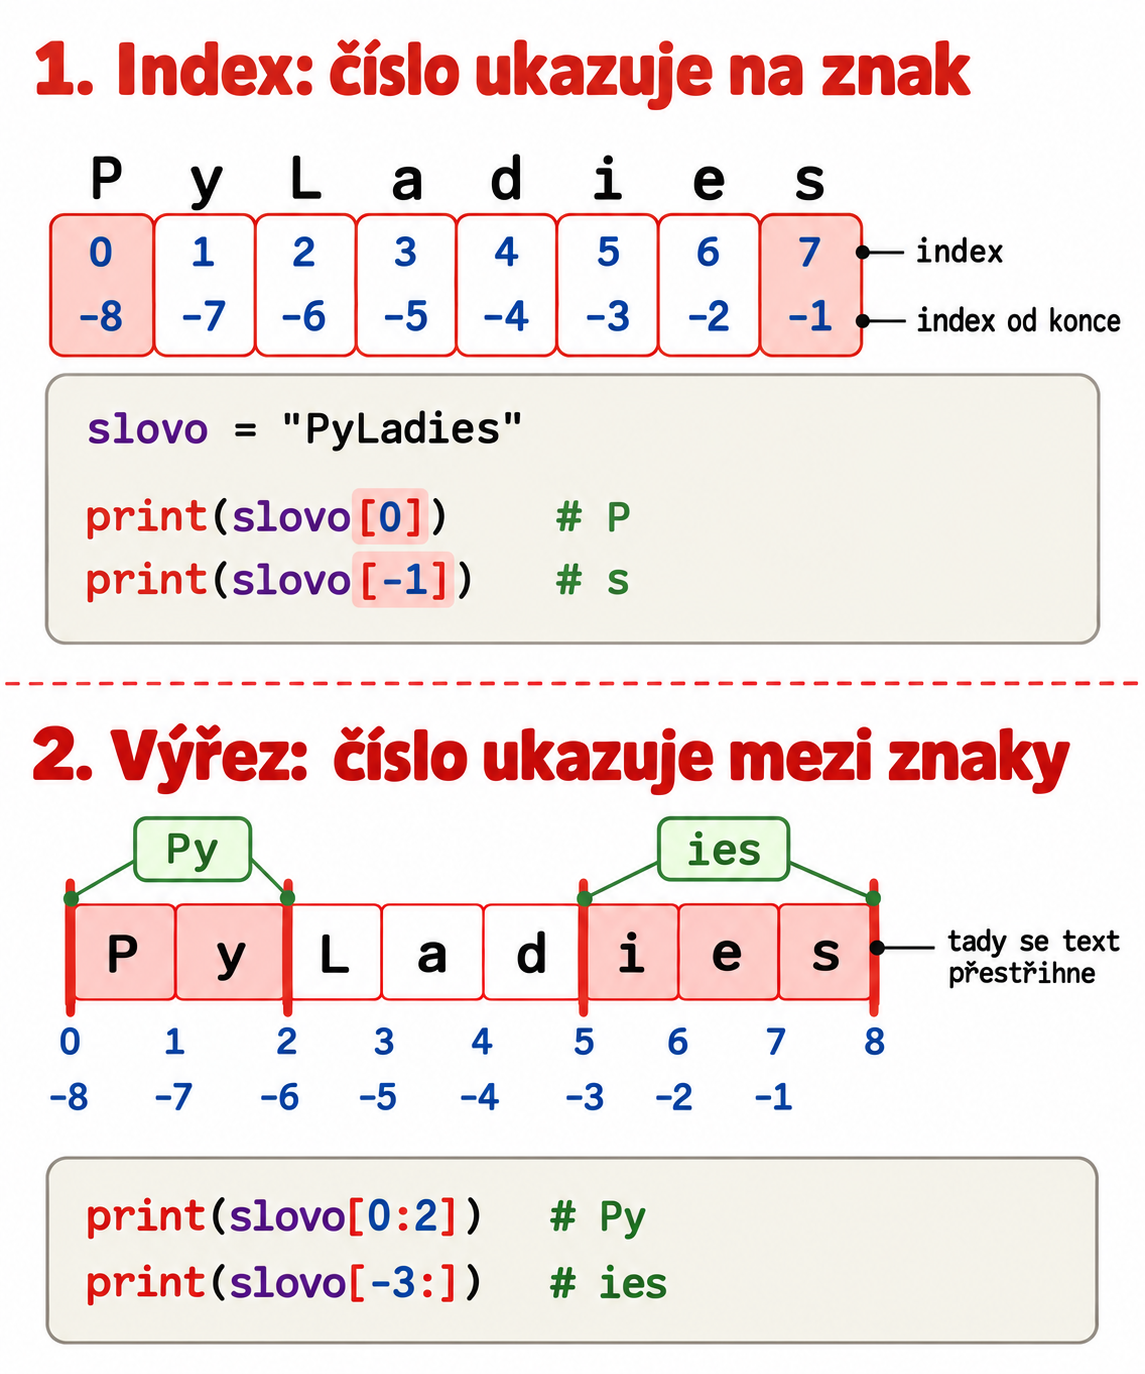
print(slovo[0])     # P
print(slovo[1])     # y
print(slovo[2])     # L
Poslední index je proto o jedna menší než délka:
print(len(slovo))   # 8
print(slovo[7])     # s
Od konce se dá počítat záporně a je to kratší:
print(slovo[-1])    # s
print(slovo[-2])    # e
Index jde dosadit i z proměnné nebo z výpočtu:
pozice = 3
print(slovo[pozice])            # a
print(slovo[len(slovo) - 1])    # s
Index, který v textu není, skončí chybou IndexError:
print(slovo[8])Zpět na téma: Indexování a výřezy · Další: Výřez: víc znaků najednou
Spusť soubor a porovnej výsledky.
slovo = "PyLadies"U výřezu se stejná čísla čtou jinak. Ukazují na značky mezi znaky, tedy na místa, kde se text přestřihne:
 ╭───┬───┬───┬───┬───┬───┬───┬───╮
 │ P │ y │ L │ a │ d │ i │ e │ s │
 ╰───┴───┴───┴───┴───┴───┴───┴───╯
 0   1   2   3   4   5   6   7   8
-8  -7  -6  -5  -4  -3  -2  -1
Výřez vezme všechno mezi dvěma značkami.
Dvojtečka mezi dvěma indexy vybere část textu. Druhé číslo se do výřezu nepočítá – stejné pravidlo jako u range:
print(slovo[0:2])       # Py
print(slovo[2:8])       # Ladies
Když první číslo chybí, bere se od začátku:
print(slovo[:2]) # PyKdyž chybí druhé, jede se až do konce:
print(slovo[2:]) # LadiesZáporné indexy fungují i tady. Poslední tři znaky a všechno kromě nich:
print(slovo[-3:])       # ies
print(slovo[:-3])       # PyLad
Za druhou dvojtečkou se dá přidat krok – o kolik znaků se pokaždé posunout:
print(slovo[::2]) # PLdeKrok -1 jde pozpátku a otočí celý text:
print(slovo[::-1]) # seidaLyPPůvodní text zůstává, jak byl – výřez je nový řetězec:
print(slovo) # PyLadiesZpět na téma: Indexování a výřezy · Další: Text se nedá přepsat
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
slovo = "palec"Index umí znak přečíst:
print(slovo[0]) # pPřepsat ho ale nejde. Zápis slovo[0] = "v" skončí chybou – na konci souboru si to vyzkoušíš. Řetězec v Pythonu jednou vznikne a od té chvíle se nemění, odborně se tomu říká neměnný. Když potřebuješ jiný, vyrobíš nový, třeba z výřezů:
novy = "v" + slovo[1:]
print(novy)         # valec
Původní zůstal, jak byl:
print(slovo) # palecOdtud taky to, co dělá upper() v předchozí složce: vrací nový řetězec, protože ten původní přepsat neumí.
Řetězec není jediná věc, která se dá indexovat a krájet. V lekci 8 potkáš seznamy – ty se chovají hodně podobně, jen se měnit dají.
Tenhle řádek skončí chybou TypeError:
slovo[0] = "v"Spusť soubor a porovnej výsledky.
slovo = "PyLadies"Zápis in znáš z cyklů, kde hledal jedno písmeno. Zvládne i delší kus:
print("Ladies" in slovo)        # True
print("ladies" in slovo)        # False
A opačná otázka, jestli tam něco není:
print("Gentlemen" not in slovo) # TrueVelikost písmen rozhoduje. Když ti nemá vadit, pomůže lower() z minulé složky:
print("ladies" in slovo.lower()) # TrueNa začátek a konec textu jsou metody:
soubor = "prezentace.pdf"

print(soubor.endswith(".pdf"))      # True
print(soubor.startswith("prez"))    # True
Hodí se to v podmínce:
if soubor.endswith(".pdf"):
    print("Tohle je PDF.")
Zpět na téma: Indexování a výřezy · Další: Cvičení: Indexování a výřezy
Každé cvičení má vlastní soubor ve složce lekce06-retezce/03_indexovani_a_vyrezy/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Soubor: cviceni/01_inicialy.py
Zeptej se na jméno a na příjmení a vypiš iniciály velkými písmeny. Pro Annu Novákovou vyjde: A. N.
jmeno = input("Jméno: ")
prijmeni = input("Příjmení: ")

print(f"{jmeno[0].upper()}. {prijmeni[0].upper()}.")Soubor: cviceni/02_posledni_znaky.py
Zeptej se na slovo a vypiš jeho poslední tři znaky. Když je slovo kratší než tři znaky, vypiš místo toho, že je moc krátké.
Délku změříš len() z lekce 3, rozhodneš se podmínkou z lekce 2.
slovo = input("Napiš slovo: ")

if len(slovo) < 3:
    print("To je moc krátké.")
else:
    print(slovo[-3:])
Se záporným indexem nepotřebuješ vědět, jak je slovo dlouhé. Výřez by u krátkého slova nespadl, jen by vrátil míň znaků – podmínka je tu proto, že chceme říct něco jiného.
Soubor: cviceni/03_datum.py
V proměnné datum je text ve tvaru rok-měsíc-den. Vypiš ho česky, tedy ve tvaru: 17. 10. 2026
datum = "2026-10-17"datum = "2026-10-17"
rok = datum[:4]
mesic = datum[5:7]
den = datum[8:10]
print(f"{den}. {mesic}. {rok}")Pomlčky sedí na indexech 4 a 7 a ve výřezech je nechceme. Proto rok končí na čtyřce, měsíc začíná na pětce a den na osmičce – čísla 4 a 7 se v nich přeskočí.
Soubor: cviceni/04_koncovka.py
Zeptej se na jméno souboru a vypiš, jestli je to obrázek, tedy jestli končí na .png
soubor = input("Jméno souboru: ")

if soubor.lower().endswith(".png"):
    print("Tohle je obrázek.")
else:
print("Tohle obrázek není.")Soubor: cviceni/05_palindrom.py
Zeptej se na slovo a vypiš, jestli se čte stejně zepředu i pozpátku. Na velikosti písmen ať nezáleží, takže "Oko" projde taky.
slovo = input("Napiš slovo: ").strip().lower()

if slovo == slovo[::-1]:
    print(f"{slovo} je palindrom.")
else:
    print(f"{slovo} palindrom není.")
Výřez s krokem -1 vrátí otočený text. Když se otočený rovná původnímu, je to palindrom.
Když si na slovo[::-1] nevzpomeneš, poskládáš otočené slovo cyklem z lekce 3 – každý další znak dáváš před ty předchozí:
otocene = ""
for znak in slovo:
    otocene = znak + otocene

print(f"Pozpátku: {otocene}")

if slovo == otocene:
    print(f"{slovo} je palindrom.")
else:
    print(f"{slovo} palindrom není.")
Obě řešení jsou správně.
Soubor: cviceni/06_oprava_indexu.py
Oprav kód a soubor spusť (Run).
Program má vypsat poslední písmeno, ale spadne. Spusť ho, přečti si hlášku a oprav ho.
slovo = "PyLadies"
print("Poslední písmeno:", slovo[len(slovo)])slovo = "PyLadies"
print(f"Poslední písmeno: {slovo[-1]}")Indexy začínají nulou, takže poslední znak má index len(slovo) - 1. Zápis slovo[-1] vyjde nastejno a je kratší.
Zpět na téma: Indexování a výřezy · Další: Bonusová cvičení: Indexování a výřezy
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce06-retezce/03_indexovani_a_vyrezy/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Soubor: cviceni_bonusy/01_skryte_cislo.py
Vypiš číslo karty tak, aby byly vidět jen poslední čtyři číslice. Zbytek nahraď hvězdičkami, ať jich je přesně tolik jako skrytých číslic.
cislo = "4539112233447788"cislo = "4539112233447788"
print("*" * (len(cislo) - 4) + cislo[-4:])Soubor: cviceni_bonusy/02_zamen_znak.py
Napiš funkci zamen, která má na vstupu text, pozici a znak. Vrátí text, který má na té pozici daný znak a jinak zůstane stejný. zamen("palec", 0, "v") vrátí "valec" zamen("valec", 2, "j") vrátí "vajec"
def zamen(text, pozice, znak):
    return text[:pozice] + znak + text[pozice + 1:]

print(zamen("palec", 0, "v"))
print(zamen("valec", 2, "j"))
Výřez před pozicí, nový znak, a výřez od dalšího znaku dál.
Soubor: cviceni_bonusy/03_nabidka_slovy.py
Napiš program, který se pořád dokola ptá, co má dělat:
kostka zeptá se, kolikrát hodit, a tolikrát hodí kostkou pozpatku zeptá se na slovo a vypíše ho pozpátku konec program skončí
Odpověď uprav tak, aby prošlo i "KOSTKA" nebo " konec ". Ošetři prázdný vstup i počet hodů, který není číslo. Na cokoli jiného vypiš, že takovou volbu neznáš, a zeptej se znovu. Na první řádek patří: from random import randrange
from random import randrange

while True:
    volba = input("Co chceš dělat? (kostka / pozpatku / konec) ")
    volba = volba.strip().lower()

    if volba == "":
        print("Nic jsi nenapsala, zkus to znovu.")
    elif volba == "konec":
        break
    elif volba == "kostka":
        pocet = input("Kolikrát hodit? ").strip()
        if pocet.isdigit():
            for hod in range(int(pocet)):
                print(f"Padlo: {randrange(1, 7)}")
        else:
            print("To není číslo.")
    elif volba == "pozpatku":
        slovo = input("Jaké slovo? ").strip()
        if slovo == "":
            print("Nemám co otočit.")
        else:
            print(f"{slovo} pozpátku je {slovo[::-1]}")
    else:
        print(f"Volbu {volba} neznám.")

print("Nashledanou!")
Nabídka, kterou jsi psala u vlastních funkcí, se ovládala čísly – text se dal moc snadno napsat jinak, než program čekal. Se strip() a lower() už na tom nezáleží a isdigit() ohlídá, co pustíš do int().