8. hodina – Seznamy a n-tice
Seznamy, index a výřez, procházení cyklem, metody seznamů jako append, pop a sort, n-tice, rozbalování a enumerate.
Výklad a cvičení
Výklad si můžeš přečíst přímo na webu. Příklady procházej po pořadí a kód si zkoušej ve VS Code.
Zpět na přehled materiálů
Seznamy
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Zpět na přehled hodiny
Proč seznam
Spusť soubor a porovnej výsledky.
Pořádáš večírek a chceš si zapsat hosty. Zatím umíš tohle:
host1 = "Anna"
host2 = "Petra"
host3 = "Jana"
Stejně sis v lekci 2 psala známky: znamka1, znamka2, znamka3. Co když
přijde dalších dvacet lidí? Na každého bys potřebovala novou proměnnou
a cyklem bys je neprošla.
Seznam drží víc hodnot v jedné proměnné. Píše se do hranatých závorek
a hodnoty oddělují čárky:
hoste = ["Anna", "Petra", "Jana"]

print(hoste)            # ['Anna', 'Petra', 'Jana']
print(len(hoste))       # 3 – počet položek v seznamu
Hodnoty stojí v pořadí, v jakém jsi je napsala, a můžou se opakovat.
Vejdou se do něj i čísla:
hlasy = [1, 2, 1, 1]

print(hlasy)            # [1, 2, 1, 1]
Do seznamu dáš jakékoli hodnoty: text, celá i desetinná čísla, True
a False, a dokonce i další seznam:
ruzne = ["Anna", 34, 1.5, True, ["dort", "víno"]]

print(ruzne)            # ['Anna', 34, 1.5, True, ['dort', 'víno']]
print(len(ruzne))       # 5 – vnitřní seznam je jedna položka
Míchat různé druhy hodnot v jednom seznamu ale nebývá dobrý nápad.
V cyklu bys u každé položky musela hlídat, co je zač. Obvykle má
seznam hodnoty jednoho druhu: samá jména, samá čísla.
Seznam může být i prázdný. Hodí se to, když hodnoty teprve přibudou:
omluveni = []

print(omluveni)         # []
print(len(omluveni))    # 0
Zpět na téma: Seznamy · Další: Index a výřez: jako u řetězců
Zdrojový Python soubor
Index a výřez: jako u řetězců
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
hoste = ["Anna", "Petra", "Jana", "Eva", "Marie", "Lucie"]
Index a výřez fungují stejně jako u řetězců z lekce 6. Index počítá
od nuly, záporný index od konce:
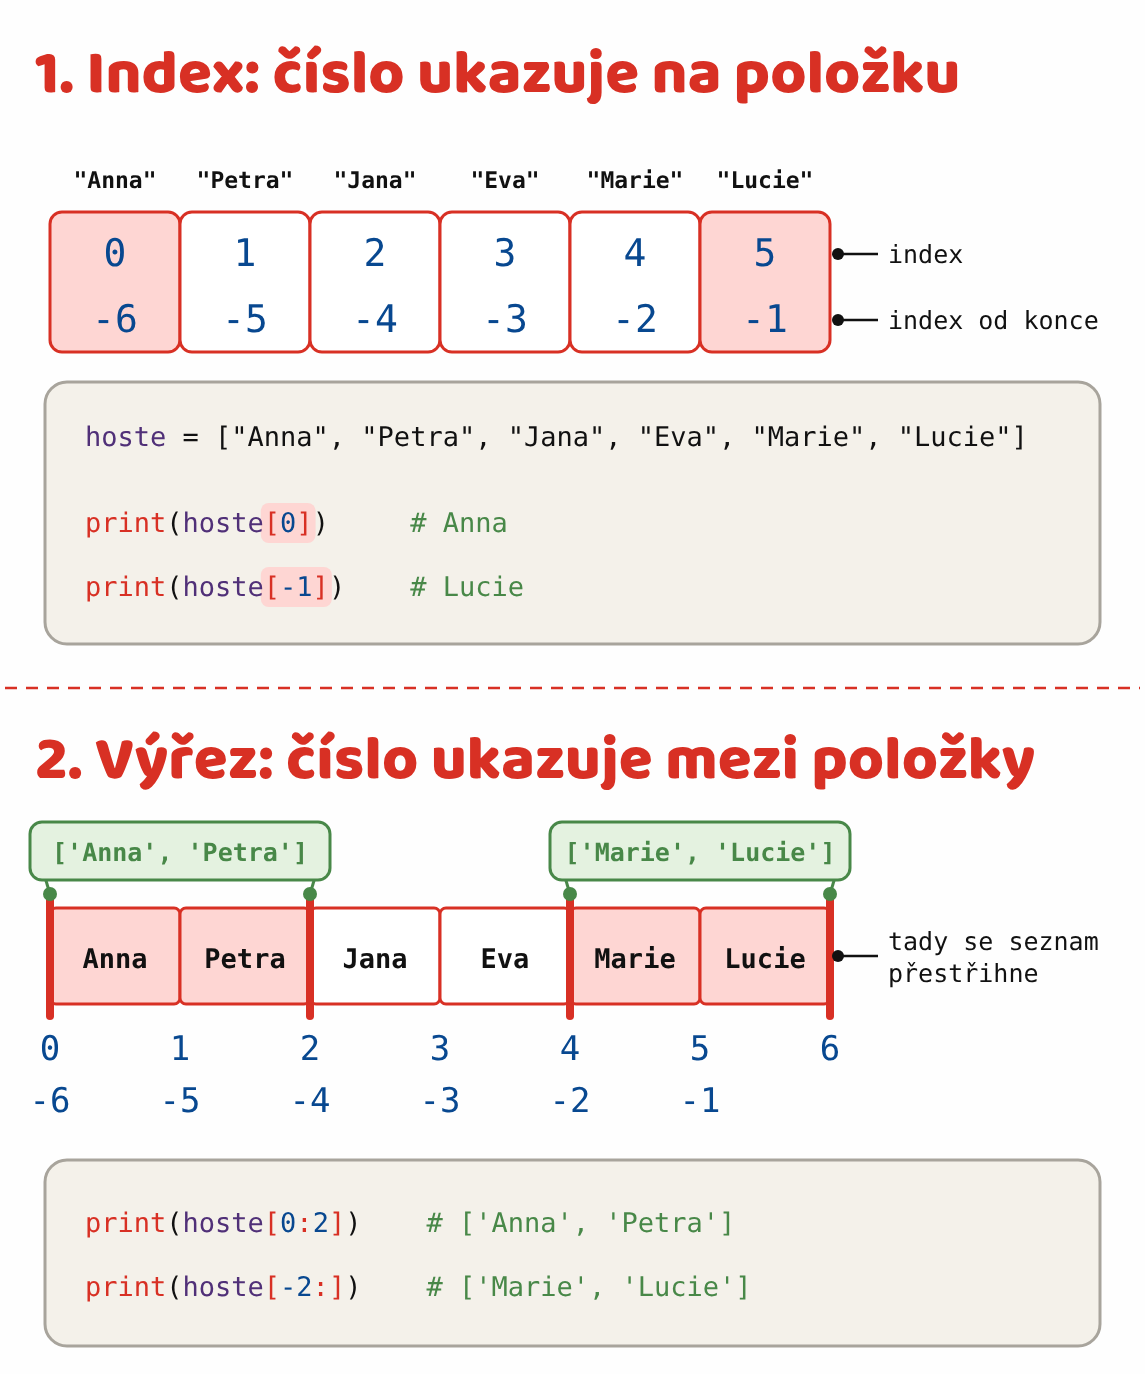
print(hoste[0])         # Anna
print(hoste[2])         # Jana
print(hoste[-1])        # Lucie
Výřez vrátí nový seznam. Číslo před dvojtečkou se do něj počítá,
číslo za dvojtečkou už ne:
prvni_dva = hoste[0:2]
print(prvni_dva)        # ['Anna', 'Petra']
Původní seznam přitom zůstane celý:
print(hoste) # ['Anna', 'Petra', 'Jana', 'Eva', 'Marie', 'Lucie']
Začátek a konec můžeš vynechat. Fungují i záporná čísla:
print(hoste[:2])        # ['Anna', 'Petra']
print(hoste[4:])        # ['Marie', 'Lucie']
print(hoste[-2:])       # ['Marie', 'Lucie']
Index je hodnota jako každá jiná, takže ho můžeš uložit do proměnné:
posledni = len(hoste) - 1
print(hoste[posledni])  # Lucie
Šest hostů má indexy 0 až 5. Index 6 už v seznamu není:
print(hoste[6]) # IndexError: list index out of range
Zpět na téma: Seznamy · Další: Procházení seznamu cyklem for
Zdrojový Python soubor
Procházení seznamu cyklem for
Spusť soubor a porovnej výsledky.
hoste = ["Anna", "Petra", "Jana", "Adéla"]
Cyklus for prochází seznam stejně jako řetězec. Místo znaků dostaneš
po jedné položce seznamu. Pozvánky jsou hotové na dva řádky:
for host in hoste:
    print(f"Milá {host}, přijď v sobotu na večírek!")
Milá Anna, přijď v sobotu na večírek!
Milá Petra, přijď v sobotu na večírek!
Milá Jana, přijď v sobotu na večírek!
Milá Adéla, přijď v sobotu na večírek!
Kolik hostů má jméno na A? V lekci 3 jsi počítala sudá čísla
v range: proměnná začne na nule a v cyklu se jí přičte jednička
pokaždé, když platí podmínka. Takové proměnné se říká počítadlo.
U seznamu to funguje stejně, jen místo čísel procházíš jména:
pocet_na_a = 0

for host in hoste:
    if host[0] == "A":
        pocet_na_a = pocet_na_a + 1

print(f"Jmen na A: {pocet_na_a}")     # Jmen na A: 2
Zpět na téma: Seznamy · Další: Hledání v seznamu a počítání s čísly
Zdrojový Python soubor
Hledání v seznamu a počítání s čísly
Spusť soubor a porovnej výsledky.
hoste = ["Anna", "Petra", "Jana"]
Zápis in znáš z lekce 3 a 6, kde hledal písmeno v textu. Stejně
zjistí, jestli je hodnota v seznamu, a vrátí True nebo False:
print("Petra" in hoste)             # True
print("Karel" in hoste)             # False
Opačnou otázku položíš zápisem not in:
print("Karel" not in hoste) # True
Pozor, tohle in není to samé jako in v cyklu for. Ve for in prochází
seznam po jedné položce, tady se jen ptá, jestli v něm hodnota je.
if "Anna" in hoste:
    print("Anna je pozvaná.")       # Anna je pozvaná.
U řetězce in hledá i kus textu. U seznamu porovnává celé položky:
print("Pet" in "Petra")             # True
print("Pet" in hoste)               # False
V lekci 6 sis u velikosti trička psala tři porovnání:
velikost = "M"

if velikost == "S" or velikost == "M" or velikost == "L":
    print("Tuhle velikost máme.")   # Tuhle velikost máme.
Se seznamem stačí jedno:
if velikost in ["S", "M", "L"]:
    print("Tuhle velikost máme.")   # Tuhle velikost máme.
Na seznam čísel fungují vestavěné funkce z lekce 3:
veky = [28, 34, 25, 41]

print(sum(veky))                    # 128
print(min(veky))                    # 25
print(max(veky))                    # 41
Průměr je součet vydělený počtem:
prumer = sum(veky) / len(veky)
print(f"Průměrný věk: {prumer:.1f}")    # Průměrný věk: 32.0
Metodu count znáš z řetězců. Spočítá, kolikrát v seznamu položka je:
napoje = ["víno", "džus", "víno", "pivo"]
print(napoje.count("víno"))         # 2
Zpět na téma: Seznamy · Další: Cvičení: Seznamy
Zdrojový Python soubor
Cvičení: Seznamy
Každé cvičení má vlastní soubor ve složce lekce08-seznamy-a-n-tice/01_seznamy/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Cvičení 1
Soubor: cviceni/01_moje_filmy.py
Vytvoř seznam pěti svých oblíbených filmů. Vypiš:
-
první film,
-
poslední film,
-
první tři filmy jako výřez,
-
všechny filmy, každý na vlastní řádek s pomlčkou na začátku,
-
kolik filmů v seznamu je.
Zobrazit řešeníSkrýt řešení
filmy = ["Pelíšky", "Amélie z Montmartru", "Vetřelec", "Ratatouille", "Matrix"]

print(filmy[0])
print(filmy[-1])
print(filmy[:3])

for film in filmy:
    print(f"- {film}")

print(f"Celkem: {len(filmy)}")
Cvičení 2
Soubor: cviceni/02_seznam_hostu.py
Zeptej se na jméno. Když je na seznamu hostů, vypiš "Vítej!".
Když není, vypiš "Na seznamu nejsi.".
Vstup uprav tak, aby prošlo i " anna " nebo "ANNA".
hoste = ["Anna", "Petra", "Jana", "Eva"]
Zobrazit řešeníSkrýt řešení
hoste = ["Anna", "Petra", "Jana", "Eva"]

jmeno = input("Jméno: ").strip().title()

if jmeno in hoste:
    print("Vítej!")
else:
    print("Na seznamu nejsi.")
Cvičení 3
Soubor: cviceni/03_platny_tah.py
Oprav kód a soubor spusť (Run).
Tuhle funkci znáš z hry v lekci 7. Přepiš ji tak, aby místo tří
porovnání používala seznam TAHY a zápis in.
KAMEN = "kamen"
NUZKY = "nuzky"
PAPIR = "papir"
TAHY = [KAMEN, NUZKY, PAPIR]

def je_platny(tah):
    return tah == KAMEN or tah == NUZKY or tah == PAPIR

print(je_platny("nuzky"))       # True
print(je_platny("pes"))         # False
Zobrazit řešeníSkrýt řešení
KAMEN = "kamen"
NUZKY = "nuzky"
PAPIR = "papir"
TAHY = [KAMEN, NUZKY, PAPIR]

def je_platny(tah):
    return tah in TAHY

print(je_platny("nuzky"))       # True
print(je_platny("pes"))         # False
Zpět na téma: Seznamy · Další: Bonusová cvičení: Seznamy
Zdrojové soubory na GitHubu
Bonusová cvičení: Seznamy
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce08-seznamy-a-n-tice/01_seznamy/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Bonus 1
Soubor: cviceni_bonusy/01_vysvedceni.py
Napiš funkci vyhodnot_vysvedceni, která má na vstupu seznam známek
a vrátí text:
"bez známek" když je seznam prázdný
"neprospěl/a" když je mezi známkami pětka
"s vyznamenáním" když je průměr nejvýš 1.5 a žádná známka
není horší než 2
"prospěl/a" jinak
Vyzkoušej ji na seznamech [1, 2, 1], [1, 3, 2], [1, 5, 1] a [].
Zobrazit řešeníSkrýt řešení
def vyhodnot_vysvedceni(znamky):
    if len(znamky) == 0:
        return "bez známek"

    prumer = sum(znamky) / len(znamky)

    if 5 in znamky:
        return "neprospěl/a"
    if prumer <= 1.5 and max(znamky) <= 2:
        return "s vyznamenáním"
    return "prospěl/a"

print(vyhodnot_vysvedceni([1, 2, 1]))       # s vyznamenáním
print(vyhodnot_vysvedceni([1, 3, 2]))       # prospěl/a
print(vyhodnot_vysvedceni([1, 5, 1]))       # neprospěl/a
print(vyhodnot_vysvedceni([]))              # bez známek
Kontrola prázdného seznamu musí být první. Jinak by funkce spadla
na dělení nulou dřív, než by se k ní dostala.
Zpět na téma: Seznamy
Zdrojové soubory na GitHubu
Měnění seznamu
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Zpět na přehled hodiny
Seznam se dá měnit
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
hoste = ["Anna", "Petra", "Jana"]
Petra poslala místo sebe sestru. Položku nahradíš tak, že do jejího
indexu přiřadíš novou hodnotu:
hoste[1] = "Marie"
print(hoste)        # ['Anna', 'Marie', 'Jana']
Eva se ozvala, že taky přijde. Metoda append přidá položku na konec:
hoste.append("Eva")
print(hoste)        # ['Anna', 'Marie', 'Jana', 'Eva']
Metody řetězců z lekce 6 vracely nový text. Metoda append mění rovnou
seznam, který už máš, proto ji není potřeba nikam ukládat.
Text změnit nejde. Tuhle chybu znáš z lekce 6:
jmeno = "Petra"
jmeno[0] = "M"      # TypeError: 'str' object does not support item assignment
Zpět na téma: Měnění seznamu · Další: Stavíme seznam v cyklu
Zdrojový Python soubor
Stavíme seznam v cyklu
Spusť soubor a porovnej výsledky. Na konci se tě zeptá na jména.
hoste = ["Anna", "Petra", "Jana"]
Tohle je nejčastější práce se seznamem: začneš s prázdným a v cyklu
do něj přidáváš.
pozvanky = []

for host in hoste:
    pozvanky.append(f"Pozvánka pro: {host}")

print(pozvanky)
['Pozvánka pro: Anna', 'Pozvánka pro: Petra', 'Pozvánka pro: Jana']
Stejně si vybereš jen některé položky. Podmínka rozhodne, co se přidá.
Tady chceš vědět, které nákupy na večírek stojí přes 100 Kč:
ceny = [120, 45, 300, 80, 150]
drahe = []

for cena in ceny:
    if cena > 100:
        drahe.append(cena)

print(drahe)                # [120, 300, 150]
print(ceny)                 # [120, 45, 300, 80, 150]
Funkce list převede range na seznam. Hodí se to třeba na čísla stolů:
stoly = list(range(1, 6))
print(stoly)                # [1, 2, 3, 4, 5]
V lekci 4 jsi v cyklu četla jména a hned je vypisovala. Potom byla
pryč. Se seznamem ti zůstanou:
prihlaseni = []

while True:
    jmeno = input("Jméno (konec = hotovo): ")
    if jmeno == "konec":
        break
    prihlaseni.append(jmeno)

print(f"Přihlášených: {len(prihlaseni)}")
print(prihlaseni)
Zpět na téma: Měnění seznamu · Další: Data zůstávají
Zdrojový Python soubor
Data zůstávají
Spusť soubor. Zeptá se tě na věk hostů.
V lekci 3 jsi počítala statistiku čísel od uživatele. V cyklu sis
průběžně hlídala součet, největší a nejmenší číslo:
soucet = soucet + cislo
if cislo > nejvetsi:
    nejvetsi = cislo
if cislo < nejmensi:
    nejmensi = cislo
Každá nová otázka by znamenala další proměnnou. Se seznamem si čísla
jen uložíš a počítáš až potom:
pocet = int(input("Kolik hostů? "))
veky = []

for i in range(pocet):
    odpoved = input("Věk: ")
    vek = int(odpoved)
    veky.append(vek)
Ty tři řádky v cyklu se dají napsat i na jeden. Vyhodnocuje se to
zevnitř ven: input, pak int, pak append.
veky.append(int(input("Věk: ")))
Kratší ale neznamená lepší. Piš to tak, jak se ti to líp čte.
print(f"Součet: {sum(veky)}")
print(f"Průměr: {sum(veky) / len(veky):.1f}")
print(f"Nejstarší: {max(veky)}")
print(f"Nejmladší: {min(veky)}")
Čísla pořád máš, takže můžeš položit otázku, se kterou jsi předtím
nepočítala:
dospeli = 0

for vek in veky:
    if vek >= 18:
        dospeli = dospeli + 1

print(f"Dospělých: {dospeli}")
Zpět na téma: Měnění seznamu · Další: Z textu seznam a zpátky
Zdrojový Python soubor
Z textu seznam a zpátky
Spusť soubor a porovnej výsledky.
Kamarádka ti poslala jména ve zprávě. Metoda split rozdělí text na
seznam podle oddělovače, který jí zadáš:
zprava = "Anna, Petra, Jana"
hoste = zprava.split(", ")

print(hoste)                # ['Anna', 'Petra', 'Jana']
print(len(hoste))           # 3
Bez oddělovače dělí split podle mezer:
print("Python je fajn".split()) # ['Python', 'je', 'fajn']
Metoda join dělá opak: z mnoha textů udělá jeden. Na první pohled
vypadá obráceně. Tečku nepíšeš za seznam, ale za text, který bude mezi
položkami. Seznam patří do závorek:
" a ".join(hoste)
─────      ─────
  │          └── seznam, který se má spojit
  └── oddělovač, který přijde mezi položky
oddelovac = " a "
veta = oddelovac.join(hoste)
print(veta)                 # Anna a Petra a Jana
Obvykle se to píše na jeden řádek, bez proměnné na oddělovač:
print(", ".join(hoste)) # Anna, Petra, Jana
Oddělovač může být jakýkoli text. Třeba recept na koktejl:
suroviny = ["rum", "limeta", "máta", "cukr"]
print(" + ".join(suroviny))     # rum + limeta + máta + cukr
Nebo prázdný text. Pak se položky slepí bez mezery:
slabiky = ["po", "hád", "ka"]
print("".join(slabiky))         # pohádka
Položky ale musí být texty. Seznam čísel join nespojí a program spadne
s chybou TypeError.
Zpět na téma: Měnění seznamu · Další: Odebírání a vkládání
Zdrojový Python soubor
Odebírání a vkládání
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
hoste = ["Anna", "Petra", "Jana", "Eva"]
Jana se omluvila. Metoda remove odebere položku podle hodnoty:
hoste.remove("Jana")
print(hoste)        # ['Anna', 'Petra', 'Eva']
Hosté přicházejí ke dveřím. Metoda pop odebere položku podle indexu
a vrátí ji. Bez indexu vezme poslední:
prvni = hoste.pop(0)
print(prvni)        # Anna
print(hoste)        # ['Petra', 'Eva']

posledni = hoste.pop()
print(posledni)     # Eva
print(hoste)        # ['Petra']
Metoda insert vloží položku na daný index. Ostatní se posunou doprava:
hoste.insert(0, "Marie")
print(hoste)        # ['Marie', 'Petra']
Když hodnota v seznamu není, remove spadne:
hoste.remove("Karel") # ValueError: list.remove(x): x not in list
Zpět na téma: Měnění seznamu · Další: Řazení a past s None
Zdrojový Python soubor
Řazení a past s None
Spusť soubor a porovnej výsledky.
hoste = ["Petra", "Anna", "Jana"]
Metoda sort seřadí přímo tenhle seznam:
hoste.sort()
print(hoste)        # ['Anna', 'Jana', 'Petra']
Metoda sort má parametr reverse s výchozí hodnotou False. Výchozí
hodnoty parametrů znáš z lekce 5. Když chceš řadit obráceně, nastavíš
ho na True. Napíšeš přitom i jeho jméno, ať je jasné, co to True znamená:
hoste.sort(reverse=True)
print(hoste)        # ['Petra', 'Jana', 'Anna']
Česká písmena s háčky skončí až za písmenem z:
jmena = ["Zuzana", "Čeněk", "Anna"]
jmena.sort()
print(jmena)        # ['Anna', 'Zuzana', 'Čeněk']
Metody append a sort mění seznam a nevracejí nic. Jejich výsledek je
None, které znáš z lekce 5. Tohle je častá past:
veky = [34, 25, 41]
serazene = veky.sort()
print(serazene)     # None
print(veky)         # [25, 34, 41]

hoste = ["Anna"]
hoste = hoste.append("Eva")
print(hoste)        # None
Metod seznamu je víc, než si teď zapamatuješ. Pamatovat si je nemusíš –
všechny z téhle lekce najdeš v taháku.
Zpět na téma: Měnění seznamu · Další: Dvě jména pro jeden seznam
Zdrojový Python soubor
Dvě jména pro jeden seznam
Spusť soubor a porovnej výsledky.
Chceš poslat kopii seznamu hostů do cateringu. Přiřazení ale seznam
nezkopíruje. Obě proměnné pak ukazují na stejný seznam:
hoste    ──╮
           ├──▶  ["Anna", "Petra"]
catering ──╯
hoste = ["Anna", "Petra"]
catering = hoste

catering.append("Šéfkuchař")

print(catering)     # ['Anna', 'Petra', 'Šéfkuchař']
print(hoste)        # ['Anna', 'Petra', 'Šéfkuchař']
Samostatný seznam dostaneš metodou copy:
hoste    ──▶  ["Anna", "Petra"]
catering ──▶  ["Anna", "Petra"]
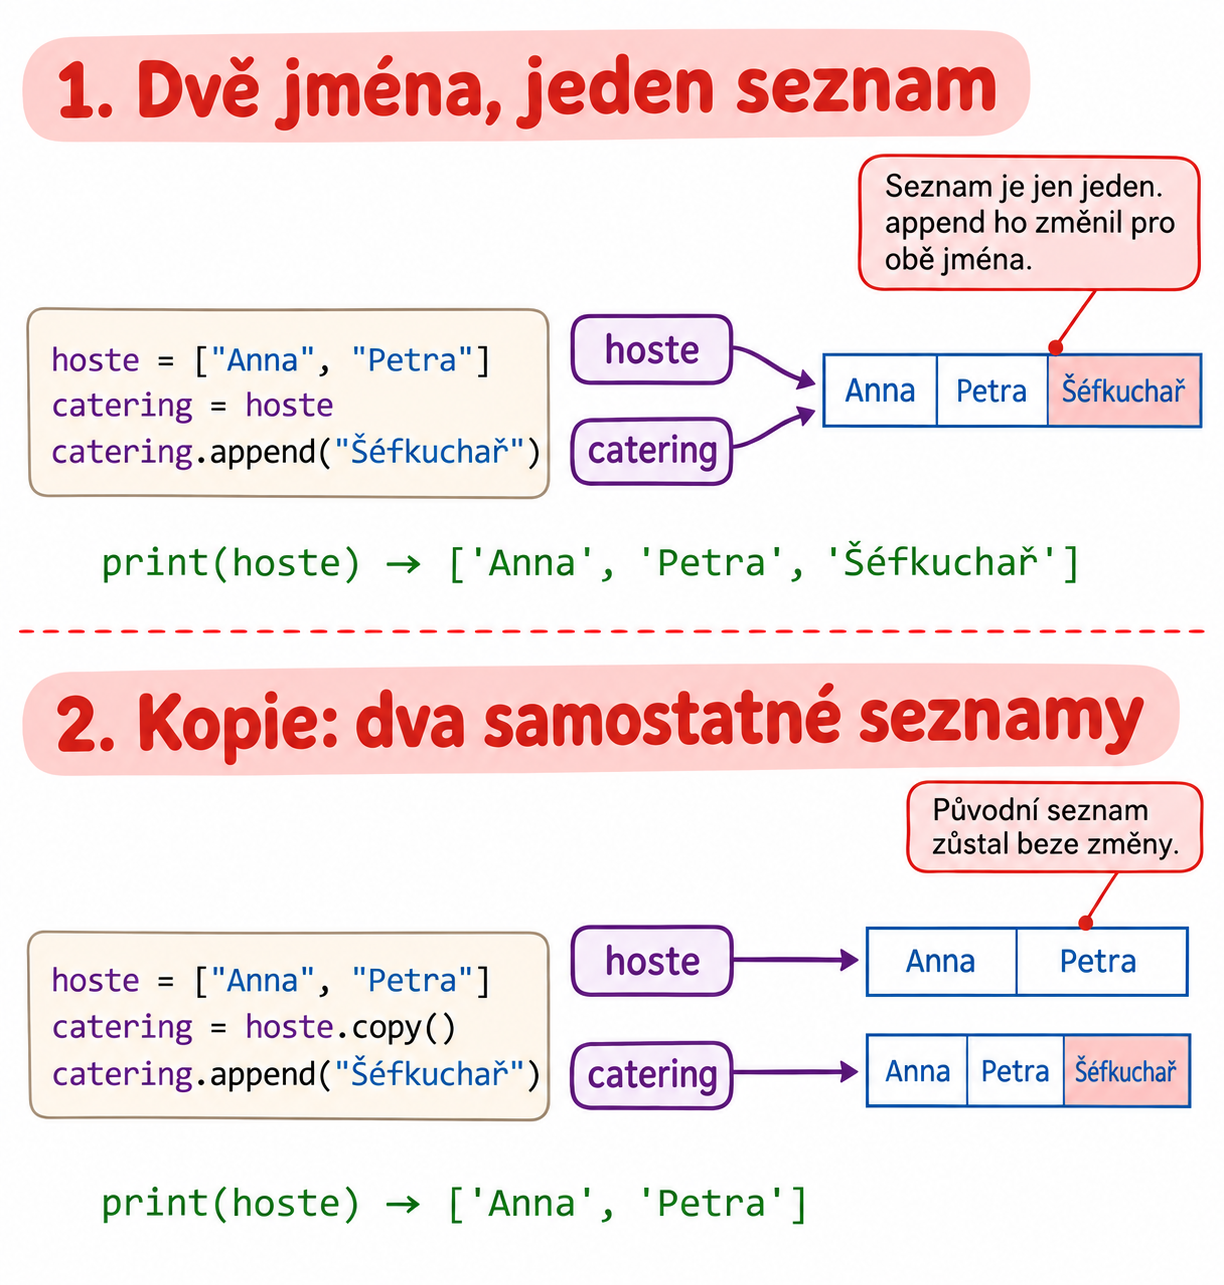
hoste = ["Anna", "Petra"]
catering = hoste.copy()

catering.append("Šéfkuchař")

print(catering)     # ['Anna', 'Petra', 'Šéfkuchař']
print(hoste)        # ['Anna', 'Petra']
Stejně je to u funkcí. Funkce dostane ten samý seznam, a když ho změní,
je to vidět i venku:
def pozvi_evu(seznam):
    seznam.append("Eva")

pozvi_evu(hoste)
print(hoste)        # ['Anna', 'Petra', 'Eva']
Výřez z první sekce taky vrací nový seznam. Je samostatný stejně jako
kopie, takže když ho změníš, původní seznam zůstane, jak byl:
hoste = ["Anna", "Petra", "Jana", "Eva"]
prvni_dva = hoste[:2]

prvni_dva.append("Šéfkuchař")

print(prvni_dva)    # ['Anna', 'Petra', 'Šéfkuchař']
print(hoste)        # ['Anna', 'Petra', 'Jana', 'Eva']
Zpět na téma: Měnění seznamu · Další: Cvičení: Měnění seznamu
Zdrojový Python soubor
Cvičení: Měnění seznamu
Každé cvičení má vlastní soubor ve složce lekce08-seznamy-a-n-tice/02_meneni_seznamu/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Cvičení 1
Soubor: cviceni/01_playlist.py
Spravuješ playlist na večírek. Postupně:
-
první skladbu přesuň na konec,
-
na druhé místo vlož přání "Jožin z bažin",
-
odeber skladbu "Holky z naší školky",
-
vypiš playlist.
Vyjít má: ['Severní vítr', 'Jožin z bažin', 'Trezor']
playlist = ["Trezor", "Severní vítr", "Holky z naší školky"]
Zobrazit řešeníSkrýt řešení
playlist = ["Trezor", "Severní vítr", "Holky z naší školky"]

prvni = playlist.pop(0)
playlist.append(prvni)
playlist.insert(1, "Jožin z bažin")
playlist.remove("Holky z naší školky")
print(playlist)
Cvičení 2
Soubor: cviceni/02_tajna_zprava.py
Kamarádka ti poslala tajnou zprávu: skrývá se v prvních písmenech
slov. Postav seznam prvních písmen a pak je spoj do jednoho slova.
Vyjít má: DORT
slova = ["Dům", "Okno", "Ryba", "Tužka"]
Zobrazit řešeníSkrýt řešení
slova = ["Dům", "Okno", "Ryba", "Tužka"]

pismena = []

for slovo in slova:
    pismena.append(slovo[0])

print("".join(pismena))
Cvičení 3
Soubor: cviceni/03_fronta.py
U fotokoutku na večírku stojí fronta. Dokud v ní někdo je, vezmi
první na řadě a vypiš "Fotí se: ...". Na konci vypiš
"Fronta je prázdná.".
fronta = ["Anna", "Petra", "Jana"]
Zobrazit řešeníSkrýt řešení
fronta = ["Anna", "Petra", "Jana"]

while len(fronta) > 0:
    host = fronta.pop(0)
    print(f"Fotí se: {host}")

print("Fronta je prázdná.")
Cvičení 4
Soubor: cviceni/04_slova_ve_vete.py
Zeptej se na větu. Vypiš, kolik má slov. Pak ji vypiš se slovy
v opačném pořadí.
Věta: Python je fajn
Slov: 3
fajn je Python
Zobrazit řešeníSkrýt řešení
veta = input("Věta: ")
slova = veta.split()

print(f"Slov: {len(slova)}")
print(" ".join(slova[::-1]))
Výřez [::-1] z lekce 6 vrátí seznam pozpátku. Kdo si na něj
nevzpomene, zvládne to i cyklem. Správně jsou obě řešení:
obracene = []

for slovo in slova:
    obracene.insert(0, slovo)

print(" ".join(obracene))
Cvičení 5
Soubor: cviceni/05_zebricek.py
Máš body ze soutěže na večírku. Seřaď je od nejvyšších a vypiš tři
nejlepší výsledky jako výřez.
Vyjít má: [18, 15, 12]
body = [12, 7, 18, 9, 15]
Zobrazit řešeníSkrýt řešení
body = [12, 7, 18, 9, 15]

body.sort(reverse=True)
print(body[:3])
Cvičení 6
Soubor: cviceni/06_oprav_kopii.py
Oprav kód a soubor spusť (Run).
Program má vypsat výsledky soutěže v pořadí, jak přišly, a vedle
nich žebříček od nejlepšího. Jenže oba seznamy vyjdou seřazené.
Najdi chybu a oprav ji. Vyjít má:
Jak přišly: [12, 18, 9, 15]
Žebříček: [18, 15, 12, 9]
vysledky = [12, 18, 9, 15]
zebricek = vysledky
zebricek.sort(reverse=True)

print(f"Jak přišly: {vysledky}")
print(f"Žebříček: {zebricek}")
Zobrazit řešeníSkrýt řešení
vysledky = [12, 18, 9, 15]
zebricek = vysledky.copy()
zebricek.sort(reverse=True)

print(f"Jak přišly: {vysledky}")
print(f"Žebříček: {zebricek}")
zebricek = vysledky nedělá kopii. Obě proměnné ukazují na stejný seznam,
takže sort seřadil i výsledky.
Cvičení 7
Soubor: cviceni/07_oprav_razeni.py
Oprav kód a soubor spusť (Run).
Funkce má vrátit jména seřazená podle abecedy, ale program vypíše
None. Najdi chybu a oprav ji.
def podle_abecedy(jmena):
    return jmena.sort()

print(podle_abecedy(["Petra", "Anna", "Jana"]))
Zobrazit řešeníSkrýt řešení
def podle_abecedy(jmena):
    jmena.sort()
    return jmena

print(podle_abecedy(["Petra", "Anna", "Jana"]))
Metoda sort seznam seřadí, ale sama vrací None. Funkce tak vracela
výsledek metody, ne seznam. Nejdřív seřaď, pak vrať seznam.
Cvičení 8
Soubor: cviceni/08_teploty_navic.py
V lekci 4 sis z naměřených teplot pamatovala jen nejvyšší. Teď si
ulož všechny. Ptej se "Teplota: ", dokud uživatel nenapíše "konec".
Pak vypiš nejvyšší teplotu, průměr a kolik teplot bylo nad průměrem.
Teplota: 10
Teplota: 20
Teplota: 30
Teplota: konec
Nejvyšší: 30
Průměr: 20.0
Nad průměrem: 1
Zobrazit řešeníSkrýt řešení
teploty = []

while True:
    odpoved = input("Teplota: ")
    if odpoved == "konec":
        break
    teploty.append(int(odpoved))

if len(teploty) == 0:
    print("Nezadala jsi žádnou teplotu.")
else:
    prumer = sum(teploty) / len(teploty)
    nad_prumerem = 0

    for teplota in teploty:
        if teplota > prumer:
            nad_prumerem = nad_prumerem + 1

    print(f"Nejvyšší: {max(teploty)}")
    print(f"Průměr: {prumer:.1f}")
    print(f"Nad průměrem: {nad_prumerem}")
Bez té podmínky by program při "konec" hned na začátku spadl: dělení
nulou (ZeroDivisionError) a max prázdného seznamu (ValueError).
Cvičení 9
Soubor: cviceni/09_zmizela_petka.py
Spusť soubor (Run). Výsledek je špatný. Najdi chybu debuggerem.
Program má ze seznamu odebrat všechny pětky, ale jedna zůstane.
Dej breakpoint na řádek s if a krokuj. V panelu Variables sleduj
znamka a znamky. Pak program oprav.
znamky = [5, 5, 1, 2]

for znamka in znamky:
    if znamka == 5:
        znamky.remove(znamka)

print(znamky)
Zobrazit řešeníSkrýt řešení
znamky = [5, 5, 1, 2]
bez_petek = []

for znamka in znamky:
    if znamka != 5:
        bez_petek.append(znamka)

print(bez_petek)
V prvním průchodu cyklus stojí na indexu 0 a remove pětku odebere.
Ostatní položky se posunou o jedno doleva, takže druhá pětka je teď
na indexu 0. Cyklus jde dál na index 1 a tu pětku přeskočí.
Seznam, který procházíš, proto neměň. Postav si nový.
Cvičení 10
Soubor: cviceni/10_odpovedi_hostu.py
Jsou tu tři chyby a každá je jiného druhu. Jednu ti ukáže chybová
hláška, další dvě najdeš debuggerem. Oprav je po jedné a po každé
opravě program spusť.
Hosté poslali odpovědi na pozvánku v jedné zprávě. Píšou, jak je
napadne, takže ano může být i " ano" nebo "Ano". Program má vypsat:
Pozvaných: 5
Přijde: 3
Přijdou: ['Anna', 'Eva', 'Jana']
Omluvení: ['Petra', 'Marie']
zprava = "Anna:ano, Petra:ne, Jana: ano, Eva:Ano, Marie:ne"

def vsechna_jmena(zprava):
    jmena = []
    for odpoved in zprava.split(", "):
        casti = odpoved.split(":")
        jmena.append(casti[0])
    return jmena

def kdo_se_omluvil(zprava):
    omluveni = []
    for odpoved in zprava.split(", "):
        casti = odpoved.split(":")
        if casti[1] != "ano":
            omluveni.append(casti[0])
    return omluveni

hoste = vsechna_jmena(zprava)
omluveni = kdo_se_omluvil(zprava)

prijdou = hoste
for host in omluveni:
    prijdou.remove(host)

prijdou = prijdou.sort()

print(f"Pozvaných: {len(hoste)}")
print(f"Přijde: {len(prijdou)}")
print(f"Přijdou: {prijdou}")
print(f"Omluvení: {omluveni}")
Zobrazit řešeníSkrýt řešení
zprava = "Anna:ano, Petra:ne, Jana: ano, Eva:Ano, Marie:ne"

def vsechna_jmena(zprava):
    jmena = []
    for odpoved in zprava.split(", "):
        casti = odpoved.split(":")
        jmena.append(casti[0])
    return jmena

def kdo_se_omluvil(zprava):
    omluveni = []
    for odpoved in zprava.split(", "):
        casti = odpoved.split(":")
        if casti[1].strip().lower() != "ano":
            omluveni.append(casti[0])
    return omluveni

hoste = vsechna_jmena(zprava)
omluveni = kdo_se_omluvil(zprava)

prijdou = hoste.copy()
for host in omluveni:
    prijdou.remove(host)

prijdou.sort()

print(f"Pozvaných: {len(hoste)}")
print(f"Přijde: {len(prijdou)}")
print(f"Přijdou: {prijdou}")
print(f"Omluvení: {omluveni}")
- TypeError: object of type 'NoneType' has no len().
Metoda sort vrací None, takže prijdou = prijdou.sort() seznam ztratí.
Stačí zavolat prijdou.sort() bez přiřazení.
Program doběhne, ale vypíše Pozvaných: 1 a Přijde: 1.
- Breakpoint do kdo_se_omluvil ukáže v panelu Variables casti.
U Jany je casti[1] " ano", u Evy "Ano". Ani jedno se nerovná "ano",
takže se počítají jako omluvené. Pomůže strip() a lower().
Přijde už je správně 3, ale Pozvaných je pořád 3 místo 5.
- Funkce jsou teď v pořádku. Breakpoint na cyklus for ukáže, že hoste
se zmenšují spolu s prijdou. Řádek prijdou = hoste nedělá kopii, obě
proměnné ukazují na stejný seznam. Pomůže hoste.copy().
Zpět na téma: Měnění seznamu · Další: Bonusová cvičení: Měnění seznamu
Zdrojové soubory na GitHubu
Bonusová cvičení: Měnění seznamu
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce08-seznamy-a-n-tice/02_meneni_seznamu/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Bonus 1
Soubor: cviceni_bonusy/01_tombola.py
Vylosuj tři výherce tomboly. Každý může vyhrát jen jednou, takže
vylosované jméno ze seznamu vždycky odeber.
Na první řádek patří: from random import choice
choice(seznam) vrátí náhodnou položku seznamu.
hoste = ["Anna", "Petra", "Jana", "Eva", "Marie"]
Zobrazit řešeníSkrýt řešení
from random import choice
hoste = ["Anna", "Petra", "Jana", "Eva", "Marie"]

for poradi in range(1, 4):
    vyherce = choice(hoste)
    hoste.remove(vyherce)
    print(f"{poradi}. cena: {vyherce}")
Bonus 2
Soubor: cviceni_bonusy/02_bez_opakovani.py
Ze seznamu postav nový seznam, ve kterém se žádná položka neopakuje
a pořadí zůstane stejné.
Vyjít má: ['pes', 'kočka', 'křeček']
zvirata = ["pes", "kočka", "pes", "křeček", "kočka"]
Zobrazit řešeníSkrýt řešení
zvirata = ["pes", "kočka", "pes", "křeček", "kočka"]

bez_opakovani = []

for zvire in zvirata:
    if zvire not in bez_opakovani:
        bez_opakovani.append(zvire)

print(bez_opakovani)
Bonus 3
Soubor: cviceni_bonusy/03_bez_nejhorsi.py
Napiš funkci bez_nejhorsi, která má na vstupu seznam známek a vrátí
nový seznam bez jedné nejhorší známky. Původní seznam se nesmí
změnit.
znamky = [1, 3, 2, 3]
print(bez_nejhorsi(znamky))     # [1, 2, 3]
print(znamky)                   # [1, 3, 2, 3]
Zobrazit řešeníSkrýt řešení
def bez_nejhorsi(znamky):
    kopie = znamky.copy()
    kopie.remove(max(kopie))
    return kopie

znamky = [1, 3, 2, 3]
print(bez_nejhorsi(znamky))     # [1, 2, 3]
print(znamky)                   # [1, 3, 2, 3]
Zpět na téma: Měnění seznamu
Zdrojové soubory na GitHubu
N-tice
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Zpět na přehled hodiny
N-tice: hodnoty, které patří k sobě
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
Každý host něco přinese. K jednomu hostu teď patří dvě různé věci: jméno
a dárek. Na to je tu n-tice. Píše se do kulatých závorek.
Odkud ten název? Dvě hodnoty jsou dvojice, tři trojice, čtyři čtveřice.
Písmeno n se v matematice píše místo čísla, které může být jakékoli.
N-tice je tedy skupina n hodnot, ať je jich kolik chce. Anglicky se jí
říká tuple, podle double a triple. To slovo uvidíš v chybových hláškách.
anna = ("Anna", "dort")             # dvojice
petra = ("Petra", "víno", 2)        # trojice

print(anna)         # ('Anna', 'dort')
print(petra)        # ('Petra', 'víno', 2)
Čtení funguje stejně jako u seznamu:
print(anna[0])      # Anna
print(len(petra))   # 3
Seznam použij, když máš víc věcí stejného druhu a jejich počet se může
měnit. To jsou hosté. N-tici použij, když je hodnot pevný počet a patří
k sobě. Často má každá pozice jiný význam, třeba jméno a dárek. Jindy
jsou hodnoty stejného druhu, třeba souřadnice (3, 5).
N-tici po vytvoření změnit nejde. Tak proč n-tice vůbec používat,
když seznam umí všechno, co ony, a ještě víc?
-
Co se měnit nemá, nezměníš omylem. Dvojice jméno a dárek zůstane
pohromadě a nikdo do ní nepřidá třetí hodnotu.
-
Kdo čte kód, hned vidí, že hodnoty patří k sobě jako celek.
-
V lekci 9 uvidíš, že n-tice může být klíčem ve slovníku. Seznam
ne, právě proto, že se dá měnit.
N-tice proto nemá append a položku v ní nenahradíš:
anna[1] = "koláč" # TypeError: 'tuple' object does not support item assignment
Zpět na téma: N-tice · Další: Rozbalování
Zdrojový Python soubor
Rozbalování
Spusť soubor. Na konci schválně spadne – tu chybu si přečti.
anna = ("Anna", "dort")
Hodnoty z n-tice můžeš uložit do proměnných najednou:
jmeno, darek = anna

print(jmeno)        # Anna
print(darek)        # dort
Je to přehlednější než indexy, které si musíš pamatovat:
print(f"{anna[0]} přinese {anna[1]}.")      # Anna přinese dort.
print(f"{jmeno} přinese {darek}.")          # Anna přinese dort.
Díky rozbalování prohodíš dvě proměnné na jednom řádku:
vlevo = "Anna"
vpravo = "Petra"
vlevo, vpravo = vpravo, vlevo

print(vlevo)        # Petra
print(vpravo)       # Anna
Počet proměnných musí sedět s počtem hodnot:
jmeno, darek = ("Petra", "víno", 2) # ValueError: too many values to unpack
Zpět na téma: N-tice · Další: Funkce, která vrací víc hodnot
Zdrojový Python soubor
Funkce, která vrací víc hodnot
Spusť soubor a porovnej výsledky.
Funkce vrací jednu hodnotu. Tou hodnotou ale může být n-tice. Tady
rozsazujeme hosty ke stolům:
def rozsad(hoste, mist_u_stolu):
    return hoste // mist_u_stolu, hoste % mist_u_stolu

print(rozsad(17, 4))    # (4, 1)
Za return nejsou závorky potřeba, čárky stačí. Výsledek hned rozbalíš:
stoly, zbyva = rozsad(17, 4)

print(f"Plných stolů: {stoly}")     # Plných stolů: 4
print(f"Zbývá hostů: {zbyva}")      # Zbývá hostů: 1
Tak může funkce vrátit i dvě hodnoty ze seznamu:
def nejmladsi_a_nejstarsi(veky):
    return min(veky), max(veky)

mladsi, starsi = nejmladsi_a_nejstarsi([34, 25, 41])
print(f"Věk od {mladsi} do {starsi}")   # Věk od 25 do 41
Zpět na téma: N-tice · Další: Seznam n-tic
Zdrojový Python soubor
Seznam n-tic
Spusť soubor a porovnej výsledky. Na konci si zahraješ kvíz.
Seznam a n-tice se dobře doplňují. Každá n-tice je jeden host a seznam
jich drží, kolik potřebuješ:
darky = [("Anna", "dort"), ("Petra", "víno"), ("Jana", "chlebíčky")]

print(darky[0])         # ('Anna', 'dort')
print(len(darky))       # 3
V cyklu for se dá každá n-tice rovnou rozbalit:
for jmeno, darek in darky:
    print(f"{jmeno} přinese {darek}.")
Anna přinese dort.
Petra přinese víno.
Jana přinese chlebíčky.
Do seznamu přidáš n-tici stejně jako cokoli jiného. Pozor na dvojí
závorky: vnitřní patří n-tici, vnější metodě append.
darky.append(("Eva", "víno"))
print(len(darky))       # 4
Postup se stavěním seznamu funguje i tady:
vino = []

for jmeno, darek in darky:
    if darek == "víno":
        vino.append(jmeno)

print(vino)             # ['Petra', 'Eva']
Na večírek chceš kvíz. V lekci 5 jsi měla na každou otázku vlastní
volání a vlastní if. Když jsou otázky s odpověďmi v seznamu dvojic,
stačí jeden cyklus a další otázku jen dopíšeš:
kviz = [
    ("Kolik je 7 * 8? ", "56"),
    ("Hlavní město Česka? ", "Praha"),
    ("Jak se jmenuje cyklus, co běží, dokud platí podmínka? ", "while"),
]
body = 0

for otazka, spravna in kviz:
    odpoved = input(otazka).strip()
    if odpoved == spravna:
        body = body + 1

print(f"Skóre: {body} z {len(kviz)}")
Zpět na téma: N-tice · Další: Enumerate: položka i její pořadí
Zdrojový Python soubor
Enumerate: položka i její pořadí
Spusť soubor a porovnej výsledky.
program = ["přípitek", "večeře", "tombola"]
Někdy potřebuješ u položky znát i její pořadí. Funkce enumerate ke
každé položce přidá číslo a vrátí dvojice, které rozbalíš:
for poradi, bod in enumerate(program):
    print(poradi, bod)
0 přípitek
1 večeře
2 tombola
Pro lidi je lepší číslovat od jedničky. Funkce enumerate má parametr
start s výchozí hodnotou 0. Nastavíš ho stejně jako reverse u řazení,
i se jménem:
for poradi, bod in enumerate(program, start=1):
    print(f"{poradi}. {bod}")
-
přípitek
-
večeře
-
tombola
Zpět na téma: N-tice · Další: Co přinese Petra?
Zdrojový Python soubor
Co přinese Petra?
Spusť soubor a porovnej výsledky.
darky = [("Anna", "dort"), ("Petra", "víno"), ("Jana", "chlebíčky")]
Chceš zjistit jednu věc: co přinese Petra. Se seznamem dvojic musíš
projít hosty jednoho po druhém, dokud ji nenajdeš:
def co_prinese(hledane_jmeno, darky):
    for jmeno, darek in darky:
        if jmeno == hledane_jmeno:
            return darek
    return None

print(co_prinese("Petra", darky))   # víno
print(co_prinese("Karel", darky))   # None
Funguje to, ale na každou otázku tohoto typu je potřeba celý cyklus.
V lekci 9 potkáš slovníky, kde si hodnotu vytáhneš rovnou podle jména.
Zpět na téma: N-tice · Další: Cvičení: N-tice
Zdrojový Python soubor
Cvičení: N-tice
Každé cvičení má vlastní soubor ve složce lekce08-seznamy-a-n-tice/03_n_tice/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Cvičení 1
Soubor: cviceni/01_kosik.py
Do košíku patří trojice: zboží, počet kusů a cena za kus. Rozbal ji
do tří proměnných a vypiš větu:
víno: 3 ks za 450 Kč
polozka = ("víno", 3, 150)
Zobrazit řešeníSkrýt řešení
polozka = ("víno", 3, 150)

zbozi, kusy, cena = polozka

print(f"{zbozi}: {kusy} ks za {kusy * cena} Kč")
Cvičení 2
Soubor: cviceni/02_samohlasky.py
Napiš funkci samohlasky_a_souhlasky, která má na vstupu slovo a vrátí
dvě hodnoty: počet samohlásek a počet souhlásek. Výsledek rozbal
a vypiš:
večírek: 3 samohlásky, 4 souhlásky
Zobrazit řešeníSkrýt řešení
def samohlasky_a_souhlasky(slovo):
    samohlasky = 0
    souhlasky = 0

    for pismeno in slovo.lower():
        if pismeno in "aáeéěiíoóuúůyý":
            samohlasky = samohlasky + 1
        else:
            souhlasky = souhlasky + 1

    return samohlasky, souhlasky

slovo = "večírek"
pocet_samohlasek, pocet_souhlasek = samohlasky_a_souhlasky(slovo)

print(f"{slovo}: {pocet_samohlasek} samohlásky, {pocet_souhlasek} souhlásky")
Cvičení 3
Soubor: cviceni/03_kviz_navic.py
Rozšiř kvíz z výkladu:
-
přidej dvě vlastní otázky,
-
před každou otázkou vypiš, kolikátá je, třeba "Otázka 2/5"
(pomůže ti enumerate),
-
na konci vypiš skóre v procentech a seznam otázek, na které
hráčka odpověděla špatně.
Otázka 1/5
Kolik je 7 * 8? 54
...
Skóre: 60 %
Špatně: ['Kolik je 7 * 8? ', 'Hlavní město Česka? ']
kviz = [
    ("Kolik je 7 * 8? ", "56"),
    ("Hlavní město Česka? ", "Praha"),
    ("Jak se jmenuje cyklus, co běží, dokud platí podmínka? ", "while"),
]
Zobrazit řešeníSkrýt řešení
kviz = [
    ("Kolik je 7 * 8? ", "56"),
    ("Hlavní město Česka? ", "Praha"),
    ("Jak se jmenuje cyklus, co běží, dokud platí podmínka? ", "while"),
    ("Jakou metodou přidáš položku na konec seznamu? ", "append"),
    ("Kolik hodnot má dvojice? ", "2"),
]
body = 0
spatne = []

for cislo, polozka in enumerate(kviz, start=1):
    otazka, spravna = polozka
    print(f"Otázka {cislo}/{len(kviz)}")
    odpoved = input(otazka).strip()
    if odpoved == spravna:
        body = body + 1
    else:
        spatne.append(otazka)

print(f"Skóre: {body / len(kviz) * 100:.0f} %")
print(f"Špatně: {spatne}")
Cvičení 4
Soubor: cviceni/04_ucet_za_vecirek.py
Jsou tu tři chyby a každá je jiného druhu. Jednu ti ukáže chybová
hláška, další dvě najdeš debuggerem. Oprav je po jedné a po každé
opravě program spusť.
Program spočítá útratu za večírek. V nákupu je zboží, počet kusů
a cena za kus. Celkovou útratu si šest hostů rozdělí rovným dílem.
Vypsat má:
Celkem: 1230 Kč
Na hosta: 205 Kč
Největší položka: víno (450 Kč)
nakup = [("víno", 3, 150), ("dort", 1, 420), ("chlebíčky", 20, 18)]
hostu = 6

def celkova_utrata(nakup):
    celkem = 0
    for zbozi, kusy in nakup:
        celkem = celkem + kusy * cena
        return celkem

def nejvetsi_polozka(nakup):
    nejvetsi = ""
    nejvic = 0
    for zbozi, kusy, cena in nakup:
        if cena > nejvic:
            nejvetsi = zbozi
            nejvic = cena
    return nejvetsi, nejvic

celkem = celkova_utrata(nakup)
zbozi, castka = nejvetsi_polozka(nakup)

print(f"Celkem: {celkem} Kč")
print(f"Na hosta: {celkem / hostu:.0f} Kč")
print(f"Největší položka: {zbozi} ({castka} Kč)")
Zobrazit řešeníSkrýt řešení
nakup = [("víno", 3, 150), ("dort", 1, 420), ("chlebíčky", 20, 18)]
hostu = 6

def celkova_utrata(nakup):
    celkem = 0
    for zbozi, kusy, cena in nakup:
        celkem = celkem + kusy * cena
    return celkem

def nejvetsi_polozka(nakup):
    nejvetsi = ""
    nejvic = 0
    for zbozi, kusy, cena in nakup:
        if kusy * cena > nejvic:
            nejvetsi = zbozi
            nejvic = kusy * cena
    return nejvetsi, nejvic

celkem = celkova_utrata(nakup)
zbozi, castka = nejvetsi_polozka(nakup)

print(f"Celkem: {celkem} Kč")
print(f"Na hosta: {celkem / hostu:.0f} Kč")
print(f"Největší položka: {zbozi} ({castka} Kč)")
- ValueError: too many values to unpack.
N-tice v nákupu mají tři hodnoty, ale cyklus rozbaluje jen dvě.
Patří tam for zbozi, kusy, cena in nakup.
Program doběhne, ale vypíše Celkem: 450 Kč.
- Breakpoint do celkova_utrata a krokování ukáže, že funkce skončí
po prvním průchodu. Řádek return je odsazený uvnitř cyklu. Patří
až za něj.
Celkem i Na hosta už sedí, ale největší položka vyšla dort.
- Breakpoint do nejvetsi_polozka ukáže, že se porovnává cena jednoho
kusu, takže vyhrává dort za 420 Kč. Víno stojí za kus jen 150 Kč,
ale tři kusy dělají 450 Kč. Porovnávat se má kusy * cena.
Zpět na téma: N-tice · Další: Bonusová cvičení: N-tice
Zdrojové soubory na GitHubu
Bonusová cvičení: N-tice
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce08-seznamy-a-n-tice/03_n_tice/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Bonus 1
Soubor: cviceni_bonusy/01_nejlepsi_a_nejhorsi.py
Napiš funkci nejlepsi_a_nejhorsi, která má na vstupu seznam dvojic
(jméno, body). Vrátí jméno s nejvíc body a jméno s nejméně body.
Když je seznam prázdný, vrátí None, None.
Vyjít má: Petra, Jana
None, None (pro prázdný seznam)
vysledky = [("Anna", 12), ("Petra", 15), ("Jana", 9)]
Zobrazit řešeníSkrýt řešení
vysledky = [("Anna", 12), ("Petra", 15), ("Jana", 9)]

def nejlepsi_a_nejhorsi(vysledky):
    if len(vysledky) == 0:
        return None, None

    nejlepsi, nejvic = vysledky[0]
    nejhorsi, nejmene = vysledky[0]

    for jmeno, body in vysledky:
        if body > nejvic:
            nejlepsi, nejvic = jmeno, body
        if body < nejmene:
            nejhorsi, nejmene = jmeno, body

    return nejlepsi, nejhorsi

prvni, posledni = nejlepsi_a_nejhorsi(vysledky)
print(f"{prvni}, {posledni}")

prvni, posledni = nejlepsi_a_nejhorsi([])
print(f"{prvni}, {posledni}")
Kontrola prázdného seznamu musí být první. Jinak by vysledky[0]
spadlo na IndexError, protože v prázdném seznamu žádná první položka
není.
Bonus 2
Soubor: cviceni_bonusy/02_dva_seznamy.py
Funkce zip prochází dva seznamy vedle sebe a vrací dvojice:
for jmeno, vek in zip(jmena, veky):
Vypiš každou osobu na vlastní řádek a spočítej, kdo je nejstarší.
Anna: 30
Petra: 41
Jana: 27
Nejstarší: Petra
jmena = ["Anna", "Petra", "Jana"]
veky = [30, 41, 27]
Zobrazit řešeníSkrýt řešení
jmena = ["Anna", "Petra", "Jana"]
veky = [30, 41, 27]

nejstarsi = ""
nejvyssi_vek = 0

for jmeno, vek in zip(jmena, veky):
    print(f"{jmeno}: {vek}")
    if vek > nejvyssi_vek:
        nejvyssi_vek = vek
        nejstarsi = jmeno

print(f"Nejstarší: {nejstarsi}")
Zpět na téma: N-tice
Zdrojové soubory na GitHubu