9. hodina – Slovníky
Slovník jako dvojice klíč a hodnota, chybějící klíč, procházení, slovník jako počítadlo a skupiny, záznamy a seznam slovníků.
Výklad a cvičení
Výklad si můžeš přečíst přímo na webu. Příklady procházej po pořadí a kód si zkoušej ve VS Code.
Zpět na přehled materiálů
Slovníky
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Zpět na přehled hodiny
Proč slovník
Spusť soubor a porovnej výsledky.
Na konci lekce 8 jsi hledala, co přinese Petra. Seznam dvojic jsi
musela projít cyklem, dokud jsi ji nenašla:
darky = [("Anna", "dort"), ("Petra", "víno"), ("Jana", "chlebíčky")]

for jmeno, darek in darky:
    if jmeno == "Petra":
        print(darek)        # víno
Slovník ukládá dvojice: klíč a hodnotu. Je trochu jako seznam, jen se
k hodnotě nedostaneš indexem, ale klíčem. Proto ho nemusíš procházet:
řekneš klíč a slovník rovnou vrátí hodnotu.
Píše se do složených závorek. Před dvojtečkou je klíč, za ní hodnota
a dvojice oddělují čárky:
darky = {"Anna": "dort", "Petra": "víno", "Jana": "chlebíčky"}
Hodnotu dostaneš rovnou podle klíče, bez cyklu:
print(darky["Petra"])       # víno

print(darky)        # {'Anna': 'dort', 'Petra': 'víno', 'Jana': 'chlebíčky'}
print(len(darky))   # 3 – počet dvojic
Když v f-stringu čteš hodnotu podle textového klíče, napiš klíč do
apostrofů. Stejné uvozovky jako kolem celého f-stringu by ho ukončily:
print(f"Petra přinese {darky['Petra']}.") # Petra přinese víno.
Odkud ten název? Funguje jako překladový slovník: najdeš slovo
a vedle něj stojí překlad. Anglicky se mu říká dictionary, v Pythonu
zkráceně dict. To slovo uvidíš v chybových hláškách.
preklady = {"pes": "dog", "kočka": "cat", "večírek": "party"}
print(preklady["večírek"])  # party
Hledá se jen jedním směrem. V telefonním seznamu najdeš podle jména
číslo, ale podle čísla jméno ne:
telefony = {"Anna": "602 111 222", "Petra": "731 333 444"}
print(telefony["Anna"])     # 602 111 222
U seznamu je klíčem pořadí (index). U slovníku si klíč vybereš sama.
Nejčastěji je to text, ale může to být i číslo:
stoly = {1: "Anna", 2: "Petra", 7: "Jana"}
print(stoly[7])             # Jana
Tady 7 neznamená osmou položku. Je to klíč 7 a slovník má jen tři dvojice.
Hodnotou může být cokoli, co znáš: text, číslo, True a False, seznam
i n-tice. Klíčem bývá text nebo číslo:
oblibene = {"Anna": ["dort", "víno"], "Petra": ["džus"]}
print(oblibene["Anna"])     # ['dort', 'víno']
V jednom slovníku můžou být hodnoty různých druhů. Když ale slovníkem
hledáš (ceník, překlady), drž hodnoty stejného druhu. Jinak bys
u každé musela hlídat, jestli s ní jde třeba počítat. Kdy je míchání
v pořádku, uvidíš ve třetí sekci.
Zpět na téma: Slovníky · Další: Když klíč chybí
Zdrojový Python soubor
Když klíč chybí
Spusť soubor. Skončí chybou, a to schválně: vysvětlení je na konci
souboru.
darky = {"Anna": "dort", "Petra": "víno", "Jana": "chlebíčky"}
Zápis in znáš z lekce 8. U slovníku hledá mezi klíči, ne mezi hodnotami:
print("Petra" in darky)     # True
print("víno" in darky)      # False – víno je hodnota, ne klíč
Čtení klíče, který ve slovníku není, skončí chybou. Uvidíš ji na konci
souboru. Proto se před čtením hodí zeptat, jestli tam klíč je:
jmeno = "Karel"

if jmeno in darky:
    print(darky[jmeno])
else:
    print(f"{jmeno} není na seznamu.")     # Karel není na seznamu.
Kratší cesta je metoda get. Když klíč chybí, nespadne a vrátí None,
které znáš z lekce 5:
print(darky.get("Petra"))   # víno
print(darky.get("Karel"))   # None
Jestli jsi dostala None, zjistíš zápisem is None:
darek = darky.get("Karel")

if darek is None:
    print("Karel nic nepřinese.")   # Karel nic nepřinese.
Proč is, a ne ==? Porovnání == se ptá, jestli mají dvě věci stejný
obsah. Zápis is se ptá, jestli jde o jednu a tutéž věc. Ten rozdíl
znáš z lekce 8: kopie seznamu má stejný obsah, ale je to jiný seznam.
hoste = ["Anna", "Petra"]
catering = hoste.copy()

print(catering == hoste)    # True – stejný obsah
print(catering is hoste)    # False – dva různé seznamy
None existuje v Pythonu jen jedno. Když se ptáš, jestli máš None,
ptáš se, jestli je to právě tohle jedno None, a to je otázka pro is.
Zápis == None by většinou fungoval taky, ale is None je přesnější
a takhle ho běžně uvidíš i v cizím kódu.
Jako druhý argument můžeš metodě get dát hodnotu, kterou má vrátit
místo None:
print(darky.get("Karel", "nic")) # nic
Klíče rozlišují velká a malá písmena. "petra" je jiný klíč než "Petra":
print("petra" in darky) # False
Když klíč chybí a čteš ho hranatými závorkami, program spadne. Je to
obdoba IndexError ze seznamů: čteš něco, co tam není.
print(darky["Karel"]) # KeyError: 'Karel'
Zpět na téma: Slovníky · Další: Slovník se dá měnit
Zdrojový Python soubor
Slovník se dá měnit
Spusť soubor a porovnej výsledky.
darky = {"Anna": "dort", "Petra": "víno"}
Slovník nemá append. Novou dvojici přidáš přiřazením:
darky["Jana"] = "chlebíčky"
print(darky)    # {'Anna': 'dort', 'Petra': 'víno', 'Jana': 'chlebíčky'}
Dvojice zůstávají v pořadí, v jakém jsi je přidala.
Stejný zápis hodnotu přepíše, když klíč už ve slovníku je. Petra si
to rozmyslela:
darky["Petra"] = "džus"
print(darky)    # {'Anna': 'dort', 'Petra': 'džus', 'Jana': 'chlebíčky'}
Každý klíč je ve slovníku jen jednou, takže druhá Petra nevznikne.
Hodnoty se opakovat můžou:
darky["Eva"] = "dort"
print(darky)    # {'Anna': 'dort', 'Petra': 'džus', 'Jana': 'chlebíčky', 'Eva': 'dort'}
Jana se omluvila. Metodu pop znáš ze seznamů. U slovníku odebere
dvojici podle klíče a vrátí její hodnotu:
darek = darky.pop("Jana")
print(darek)    # chlebíčky
print(darky)    # {'Anna': 'dort', 'Petra': 'džus', 'Eva': 'dort'}
Hodnotu můžeš změnit i výpočtem. Kolik kdo vypil sklenek:
sklenky = {"Anna": 1, "Petra": 2}

sklenky["Anna"] = sklenky["Anna"] + 1
print(sklenky)  # {'Anna': 2, 'Petra': 2}
Je to stejné jako pocet = pocet + 1 z lekce 3. Nejdřív se vyhodnotí
pravá strana: přečte se 1, přičte se 1 a výsledek 2 se uloží zpátky
pod klíč "Anna".
Zpět na téma: Slovníky · Další: Procházení slovníku
Zdrojový Python soubor
Procházení slovníku
Spusť soubor a porovnej výsledky.
darky = {"Anna": "dort", "Petra": "víno", "Jana": "chlebíčky"}
Cyklus for prochází klíče:
for jmeno in darky:
    print(jmeno)
Anna
Petra
Jana
Hodnotu si ke klíči přečteš jako obvykle:
for jmeno in darky:
    print(f"{jmeno} přinese {darky[jmeno]}.")
Anna přinese dort.
Petra přinese víno.
Jana přinese chlebíčky.
Metoda values vrátí jen hodnoty:
for darek in darky.values():
    print(darek)
dort
víno
chlebíčky
Když hodnoty rovnou vypíšeš, vypadá to zvláštně. V cyklu nebo v sum
se s nimi ale pracuje jako se seznamem:
print(darky.values()) # dict_values(['dort', 'víno', 'chlebíčky'])
Metoda items vrátí dvojice klíč–hodnota. Rozbalíš je stejně jako
seznam n-tic v lekci 8. Je to nejčastější způsob, jak slovník projít:
for jmeno, darek in darky.items():
    print(f"{jmeno} přinese {darek}.")
Anna přinese dort.
Petra přinese víno.
Jana přinese chlebíčky.
Na čísla ve slovníku fungují sum, min a max. Stačí jim dát hodnoty:
utrata = {"víno": 450, "dort": 420, "chlebíčky": 360}

print(sum(utrata.values()))     # 1230
print(max(utrata.values()))     # 450
Funkce max vrátí jen nejvyšší částku, ne zboží, ke kterému patří.
Jak najít i klíč, uvidíš v další sekci.
Shrnutí:
for klic in slovnik: jen klíče
for hodnota in slovnik.values(): jen hodnoty
for klic, hodnota in slovnik.items(): obojí
Pamatovat si to nemusíš – všechno ze slovníků najdeš v taháku.
Zpět na téma: Slovníky · Další: Stavíme slovník v cyklu
Zdrojový Python soubor
Stavíme slovník v cyklu
Spusť soubor a porovnej výsledky.
Slovník může být prázdný. Píše se jako prázdné složené závorky:
hlasy = {}
print(hlasy)            # {}
print(len(hlasy))       # 0
V lekci 8 jsi stavěla seznam: začala jsi prázdným a v cyklu přidávala.
Se slovníkem je to stejné, jen místo append přiřazuješ pod klíč.
Tak převedeš seznam dvojic z lekce 8 na slovník:
darky_seznam = [("Anna", "dort"), ("Petra", "víno"), ("Jana", "chlebíčky")]

darky = {}
for jmeno, darek in darky_seznam:
    darky[jmeno] = darek

print(darky)            # {'Anna': 'dort', 'Petra': 'víno', 'Jana': 'chlebíčky'}
print(darky["Petra"])   # víno
Hodnotu můžeš i spočítat. Kolik písmen má které jméno:
hoste = ["Anna", "Petra", "Jana"]

delky = {}
for jmeno in hoste:
    delky[jmeno] = len(jmeno)

print(delky)            # {'Anna': 4, 'Petra': 5, 'Jana': 4}
Klíče můžou být i čísla. Na začátku večírku nesedí u žádného ze tří
stolů nikdo:
u_stolu = {}
for stul in range(1, 4):
    u_stolu[stul] = 0

print(u_stolu)          # {1: 0, 2: 0, 3: 0}
Slovník postavíš i z textu. Metoda split ti vrátí seznam a ten se dá
rozbalit stejně jako n-tice:
zprava = "Anna:dort, Petra:víno, Jana:chlebíčky"

darky = {}
for odpoved in zprava.split(", "):
    jmeno, darek = odpoved.split(":")
    darky[jmeno] = darek

print(darky)            # {'Anna': 'dort', 'Petra': 'víno', 'Jana': 'chlebíčky'}
Zpět na téma: Slovníky · Další: Seznam vs slovník – kdy použít který
Zdrojový Python soubor
Seznam vs slovník – kdy použít který
Spusť soubor a porovnej výsledky.
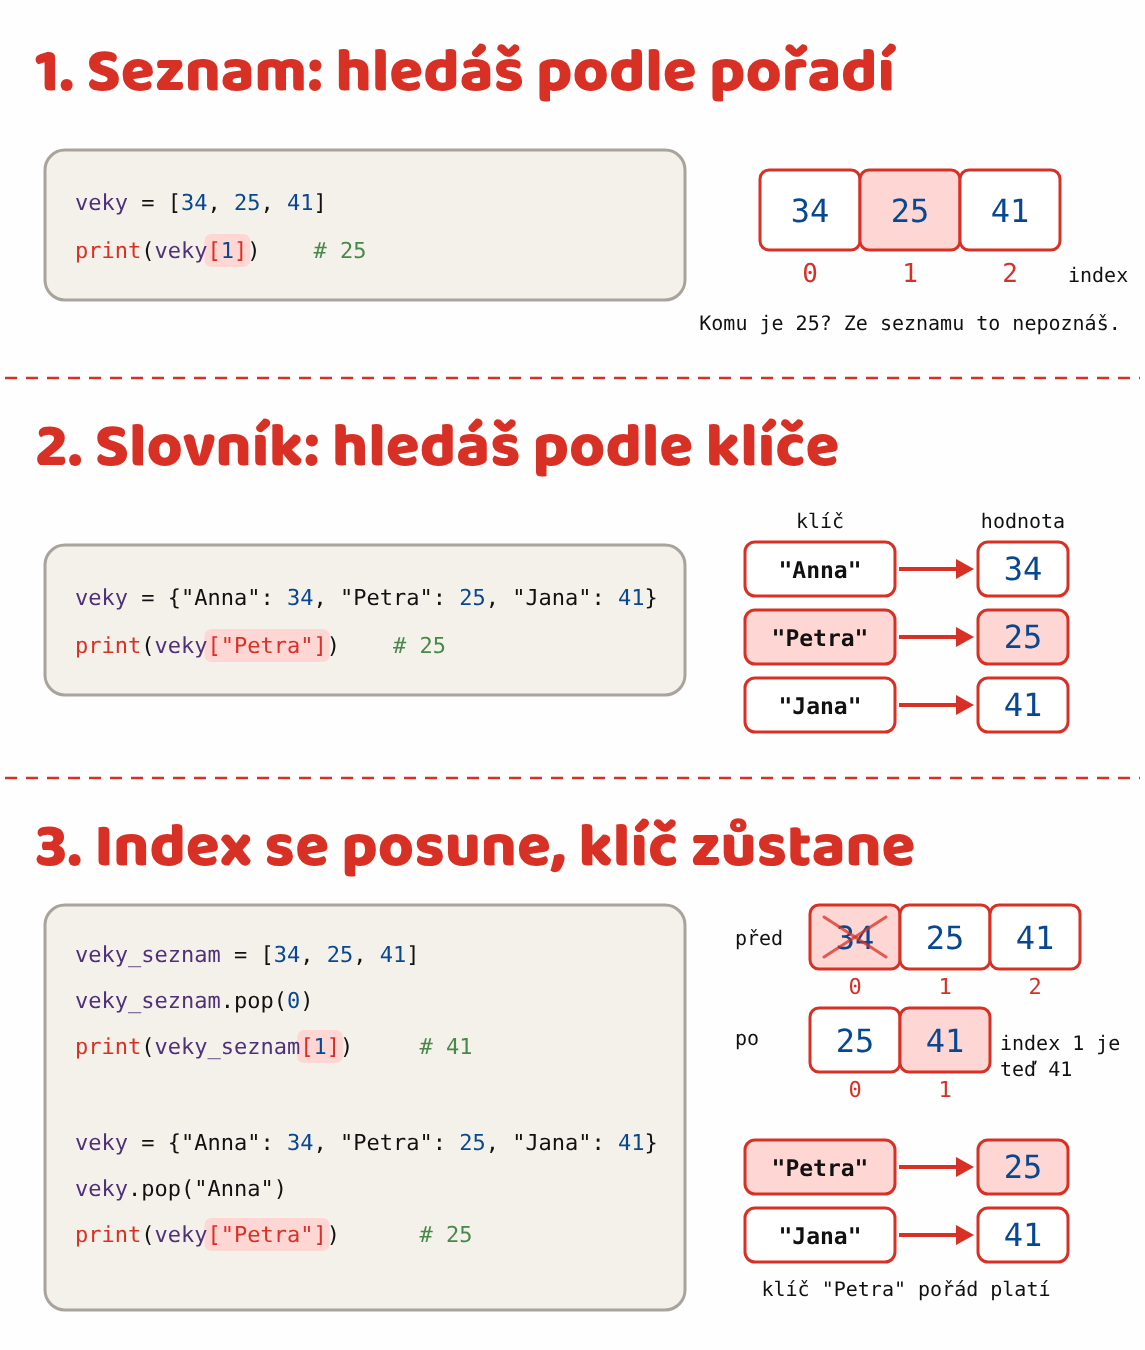
Oba drží víc hodnot. Liší se tím, jak se k nim dostaneš:
seznam – hodnoty stojí v pořadí a sahá se na ně indexem 0, 1, 2…
slovník – každá hodnota má klíč, který si zvolíš, a sahá se podle něj
Stejná data oběma způsoby. Kolik let je Petře?
Seznamem: musíš vědět, že Petra je druhá, tedy index 1. Ze seznamu
samotného to nepoznáš:
veky_seznam = [34, 25, 41]
print(veky_seznam[1])   # 25
Slovníkem: zeptáš se rovnou na Petru:
veky = {"Anna": 34, "Petra": 25, "Jana": 41}
print(veky["Petra"])    # 25
Index se navíc posouvá. Když Anna odejde, Petra je najednou první:
veky_seznam.pop(0)
print(veky_seznam[1])   # 41 – to už je Jana
Klíč zůstává, ať se ve slovníku děje cokoli:
veky.pop("Anna")
print(veky["Petra"])    # 25
Kdy co:
seznam – záleží na pořadí, nebo hodnoty nemají jméno:
fronta, playlist, naměřené teploty, žebříček
slovník – hledáš podle jména nebo kódu:
ceník, telefonní seznam, překlady, kdo co přinese
N-tice z lekce 8 se dál hodí na pevnou skupinu hodnot, které patří
k sobě, třeba jméno a dárek.
Zpět na téma: Slovníky · Další: Cvičení: Slovníky
Zdrojový Python soubor
Cvičení: Slovníky
Každé cvičení má vlastní soubor ve složce lekce09-slovniky/01_slovniky/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Cvičení 1
Soubor: cviceni/01_bar.py
Na večírku je bar a tohle je jeho ceník. Postupně:
Voda stojí 20 Kč.
{'pivo': 50, 'víno': 60, 'džus': 35, 'cola': 40}
Položek: 4
cenik = {"pivo": 45, "víno": 60, "džus": 35, "voda": 20}
Zobrazit řešeníSkrýt řešení
Klíč v apostrofech – proč, najdeš v 01_proc_slovnik.py.
print(f"Voda stojí {cenik['voda']} Kč.")

cenik["cola"] = 40
cenik["pivo"] = cenik["pivo"] + 5
cenik.pop("voda")

print(cenik)
print(f"Položek: {len(cenik)}")
Cvičení 2
Soubor: cviceni/02_oprav_cenik.py
Oprav kód a soubor spusť (Run).
Program se zeptá na nápoj a vypíše jeho cenu. Když ale napíšeš
"Pivo" nebo " pivo", spadne. Spadne i na "rum". Spusť ho, přečti si
hlášku a oprav ho tak, aby:
-
prošlo i velké písmeno a mezery navíc,
-
na nápoj, který není v ceníku, vypsal "Tohle nemáme.".
cenik = {"pivo": 45, "víno": 60, "džus": 35}

napoj = input("Co si dáš? ")
print(f"{napoj} stojí {cenik[napoj]} Kč.")
Zobrazit řešeníSkrýt řešení
cenik = {"pivo": 45, "víno": 60, "džus": 35}

napoj = input("Co si dáš? ").strip().lower()

if napoj in cenik:
    print(f"{napoj} stojí {cenik[napoj]} Kč.")
else:
    print("Tohle nemáme.")
Cvičení 3
Soubor: cviceni/03_ucet.py
Petra si u baru objednala několik nápojů. Spočítej, kolik zaplatí.
Nápoj, který v ceníku není, nepočítej a vypiš "Tohle nemáme: ...".
Tohle nemáme: šampaňské
Celkem: 185 Kč
cenik = {"pivo": 45, "víno": 60, "džus": 35, "voda": 20}
objednavka = ["pivo", "víno", "šampaňské", "pivo", "džus"]
Zobrazit řešeníSkrýt řešení
cenik = {"pivo": 45, "víno": 60, "džus": 35, "voda": 20}
objednavka = ["pivo", "víno", "šampaňské", "pivo", "džus"]

celkem = 0

for napoj in objednavka:
    if napoj in cenik:
        celkem = celkem + cenik[napoj]
    else:
        print(f"Tohle nemáme: {napoj}")

print(f"Celkem: {celkem} Kč")
Cvičení 4
Soubor: cviceni/04_telefonni_seznam.py
Telefonní seznam. Ptej se "Jméno: ", dokud uživatel nenapíše "konec".
-
Jméno uprav, ať projde i " anna" nebo "ANNA".
-
Prázdné jméno přeskoč a zeptej se znovu.
-
Když jméno v seznamu je, vypiš číslo.
-
Když není, zeptej se "Číslo: " a ulož si ho.
Na konci vypiš celý seznam, každé jméno na vlastní řádek.
Jméno: anna
602 111 222
Jméno: Eva
Číslo: 777 555 666
Jméno: EVA
777 555 666
Jméno: konec
Anna: 602 111 222
Petra: 731 333 444
Eva: 777 555 666
telefony = {"Anna": "602 111 222", "Petra": "731 333 444"}
Zobrazit řešeníSkrýt řešení
telefony = {"Anna": "602 111 222", "Petra": "731 333 444"}

while True:
    jmeno = input("Jméno: ").strip().lower()
    if jmeno == "konec":
        break
    if jmeno == "":
        continue

    jmeno = jmeno.title()
    if jmeno in telefony:
        print(telefony[jmeno])
    else:
        telefony[jmeno] = input("Číslo: ").strip()

for jmeno, cislo in telefony.items():
    print(f"{jmeno}: {cislo}")
Vstup se nejdřív zbaví mezer a převede na malá písmena. Díky tomu
projde i "KONEC". Teprve potom dostane jméno velké první písmeno,
aby sedělo s klíči ve slovníku.
Cvičení 5
Soubor: cviceni/05_prekladac.py
Napiš funkci preloz, která má na vstupu větu a slovník s překlady.
Vrátí větu přeloženou slovo po slově. Slova, která ve slovníku
nejsou, nechá, jak jsou. Velikost písmen ve větě nehraje roli.
Pak se zeptej na větu a vypiš její překlad. Větu piš bez tečky
a čárek.
Věta: Kočka pije mléko
cat drinks milk
Věta: pes jí knedlík
dog eats knedlík
slovnik = {
    "pes": "dog",
    "kočka": "cat",
    "jí": "eats",
    "pije": "drinks",
    "mléko": "milk",
    "maso": "meat",
    "a": "and",
}
Zobrazit řešeníSkrýt řešení
slovnik = {
    "pes": "dog",
    "kočka": "cat",
    "jí": "eats",
    "pije": "drinks",
    "mléko": "milk",
    "maso": "meat",
    "a": "and",
}

def preloz(veta, slovnik):
    prelozena = []
    for slovo in veta.lower().split():
        if slovo in slovnik:
            prelozena.append(slovnik[slovo])
        else:
            prelozena.append(slovo)
    return " ".join(prelozena)

veta = input("Věta: ")
print(preloz(veta, slovnik))
Podmínku v cyklu jde zkrátit metodou get. Když slovo ve slovníku není,
vrátí místo překladu slovo samotné:
prelozena.append(slovnik.get(slovo, slovo))
Funkce větu nevypisuje, ale vrací. Díky tomu ji můžeš vyzkoušet i bez
psaní do terminálu:
print(preloz("pes a kočka", slovnik)) # dog and cat
Proč bez tečky? Metoda split dělí jen podle mezer, takže z věty
"Kočka pije mléko." vznikne slovo "mléko." i s tečkou. Takový klíč
ve slovníku není a slovo zůstane nepřeložené.
Cvičení 6
Soubor: cviceni/06_morseovka.py
Napiš funkci do_morseovky, která má na vstupu text a vrátí ho
v Morseově abecedě:
-
písmena oddělí mezerou,
-
mezeru mezi slovy zapíše jako "/",
-
znak, který ve slovníku není (třeba "č"), zapíše jako "?",
-
velikost písmen nehraje roli.
Pak se zeptej na text a vypiš ho v morseovce.
Text: Ahoj Petro
.- .... --- .--- / .--. . - .-. ---
MORSE = {
    "a": ".-", "b": "-...", "c": "-.-.", "d": "-..", "e": ".",
    "f": "..-.", "g": "--.", "h": "....", "i": "..", "j": ".---",
    "k": "-.-", "l": ".-..", "m": "--", "n": "-.", "o": "---",
    "p": ".--.", "q": "--.-", "r": ".-.", "s": "...", "t": "-",
    "u": "..-", "v": "...-", "w": ".--", "x": "-..-", "y": "-.--",
    "z": "--..",
}
Zobrazit řešeníSkrýt řešení
MORSE = {
    "a": ".-", "b": "-...", "c": "-.-.", "d": "-..", "e": ".",
    "f": "..-.", "g": "--.", "h": "....", "i": "..", "j": ".---",
    "k": "-.-", "l": ".-..", "m": "--", "n": "-.", "o": "---",
    "p": ".--.", "q": "--.-", "r": ".-.", "s": "...", "t": "-",
    "u": "..-", "v": "...-", "w": ".--", "x": "-..-", "y": "-.--",
    "z": "--..",
}

def do_morseovky(text):
    znacky = []
    for znak in text.lower():
        if znak == " ":
            znacky.append("/")
        elif znak in MORSE:
            znacky.append(MORSE[znak])
        else:
            znacky.append("?")
    return " ".join(znacky)

text = input("Text: ").strip()
print(do_morseovky(text))
Poslední dvě větve jde zkrátit metodou get:
else:
    znacky.append(MORSE.get(znak, "?"))
Zpět na téma: Slovníky · Další: Bonusová cvičení: Slovníky
Zdrojové soubory na GitHubu
Bonusová cvičení: Slovníky
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce09-slovniky/01_slovniky/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Bonus 1
Soubor: cviceni_bonusy/01_scrabble.py
V naší verzi Scrabblu má každé písmeno svoji hodnotu. Napiš funkci
body_za_slovo, která má na vstupu slovo a vrátí součet bodů za jeho
písmena.
Písmena, která ve slovníku nejsou, mají 0 bodů.
Pak se zeptej na dvě slova a vypiš, které má víc bodů.
První slovo: pes
Druhé slovo: kočka
pes: 3 b.
kočka: 8 b.
Vyhrává kočka.
BODY = {
    "a": 1, "e": 1, "i": 1, "o": 1, "n": 1, "s": 1, "t": 1, "v": 1,
    "d": 1, "k": 1, "l": 1, "p": 1, "r": 1, "m": 2, "u": 2, "y": 2,
    "b": 3, "c": 3, "j": 2, "z": 2, "h": 2, "č": 4, "ž": 4, "š": 4,
    "f": 5, "g": 5, "x": 10,
}
Zobrazit řešeníSkrýt řešení
BODY = {
    "a": 1, "e": 1, "i": 1, "o": 1, "n": 1, "s": 1, "t": 1, "v": 1,
    "d": 1, "k": 1, "l": 1, "p": 1, "r": 1, "m": 2, "u": 2, "y": 2,
    "b": 3, "c": 3, "j": 2, "z": 2, "h": 2, "č": 4, "ž": 4, "š": 4,
    "f": 5, "g": 5, "x": 10,
}

def body_za_slovo(slovo):
    soucet = 0
    for pismeno in slovo.lower():
        soucet = soucet + BODY.get(pismeno, 0)
    return soucet

prvni = input("První slovo: ")
druhe = input("Druhé slovo: ")

body_prvni = body_za_slovo(prvni)
body_druhe = body_za_slovo(druhe)

print(f"{prvni}: {body_prvni} b.")
print(f"{druhe}: {body_druhe} b.")

if body_prvni > body_druhe:
    print(f"Vyhrává {prvni}.")
elif body_druhe > body_prvni:
    print(f"Vyhrává {druhe}.")
else:
    print("Remíza.")
Bonus 2
Soubor: cviceni_bonusy/02_obraceny_seznam.py
Ve slovníku se hledá jen podle klíče. Někdo ti volá z čísla
731 333 444 a ty chceš vědět, kdo to je.
Napiš funkci otoc_slovnik, která má na vstupu slovník a vrátí nový slovník,
kde jsou klíče a hodnoty prohozené. Pak v něm číslo najdi.
Volá: Petra
telefony = {"Anna": "602 111 222", "Petra": "731 333 444", "Jana": "608 999 000"}
Zobrazit řešeníSkrýt řešení
telefony = {"Anna": "602 111 222", "Petra": "731 333 444", "Jana": "608 999 000"}

def otoc_slovnik(slovnik):
    otoceny = {}
    for klic, hodnota in slovnik.items():
        otoceny[hodnota] = klic
    return otoceny

podle_cisla = otoc_slovnik(telefony)
print(f"Volá: {podle_cisla['731 333 444']}")
Pozor: kdyby dva lidé měli stejné číslo, v otočeném slovníku zůstane
jen poslední z nich. Klíč může být ve slovníku jen jednou.
Zpět na téma: Slovníky
Zdrojové soubory na GitHubu
Počítání a skupiny
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Zpět na přehled hodiny
Slovník jako počítadlo
Spusť soubor a porovnej výsledky.
Hosté hlasovali, která písnička na večírku zazní jako první:
hlasy = ["Trezor", "Jožin z bažin", "Trezor", "Holky z naší školky",
         "Trezor", "Jožin z bažin"]
Metodou count z lekce 8 spočítáš hlasy pro jednu písničku:
print(hlasy.count("Trezor")) # 3
Na všechny písničky bys ale musela předem vědět, které to jsou,
a zavolat count pro každou zvlášť. Slovník spočítá všechny najednou,
za jeden průchod cyklem. Klíč je písnička a hodnota počet hlasů.
V první sekci jsi přičítala sklenky řádkem
sklenky["Anna"] = sklenky["Anna"] + 1. Tady by stejný řádek spadl hned
u prvního hlasu:
pocty = {}
pocty["Trezor"] = pocty["Trezor"] + 1     KeyError: 'Trezor'
Pravá strana čte klíč, který ve slovníku ještě není. Proto se nejdřív
zeptáš, jestli tam písnička už je:
pocty = {}

for pisnicka in hlasy:
    if pisnicka in pocty:
        pocty[pisnicka] = pocty[pisnicka] + 1
    else:
        pocty[pisnicka] = 1

print(pocty)    # {'Trezor': 3, 'Jožin z bažin': 2, 'Holky z naší školky': 1}
Když písnička ve slovníku ještě není, dostane první hlas. Když už tam
je, přičte se jí jednička. Je to počítadlo z lekce 3, jen jich máš
tolik, kolik je různých písniček.
Totéž jde napsat kratší cestou, metodou get. Vrátí dosavadní počet
hlasů, nebo 0, když písnička ještě žádný nemá:
pocty = {}

for pisnicka in hlasy:
    pocty[pisnicka] = pocty.get(pisnicka, 0) + 1

print(pocty)    # {'Trezor': 3, 'Jožin z bažin': 2, 'Holky z naší školky': 1}
Oba zápisy dělají totéž. Používej ten, kterému rozumíš líp.
Text se prochází po znacích (lekce 3), takže stejně spočítáš písmena:
pismena = {}

for pismeno in "ananas":
    if pismeno in pismena:
        pismena[pismeno] = pismena[pismeno] + 1
    else:
        pismena[pismeno] = 1

print(pismena)  # {'a': 3, 'n': 2, 's': 1}
Zpět na téma: Počítání a skupiny · Další: Kdo vyhrál
Zdrojový Python soubor
Kdo vyhrál
Spusť soubor a porovnej výsledky.
pocty = {"Trezor": 3, "Jožin z bažin": 2, "Holky z naší školky": 1}
Funkce max ti řekne nejvyšší počet hlasů, ale ne písničku:
print(max(pocty.values())) # 3
Vítěze najdeš stejným cyklem, jakým jsi v lekci 3 hledala největší
číslo. Jen si k počtu pamatuješ i klíč.
Na začátku vítěze ještě neznáš, proto je v proměnné None, tedy „nic“
(lekce 5). Když nikdo nehlasoval a slovník je prázdný, cyklus
neproběhne ani jednou a vitez zůstane None. Podle toho to poznáš:
if vitez is None.
vitez = None
nejvic = 0

for pisnicka, pocet in pocty.items():
    if pocet > nejvic:
        vitez = pisnicka
        nejvic = pocet

print(f"Vyhrála písnička {vitez} ({nejvic} hlasy).")
Vyhrála písnička Trezor (3 hlasy).
Co když mají dvě písničky stejně hlasů? Porovnání > pustí dál jen
větší počet, takže vyhraje ta, která byla ve slovníku dřív:
pocty = {"Trezor": 2, "Jožin z bažin": 2}

vitez = None
nejvic = 0

for pisnicka, pocet in pocty.items():
    if pocet > nejvic:
        vitez = pisnicka
        nejvic = pocet

print(vitez)    # Trezor
Když chceš všechny vítěze, najdi nejdřív nejvyšší počet a pak posbírej
všechny písničky, které ho mají:
nejvic = max(pocty.values())

vitezove = []
for pisnicka, pocet in pocty.items():
    if pocet == nejvic:
        vitezove.append(pisnicka)

print(vitezove)     # ['Trezor', 'Jožin z bažin']
Zpět na téma: Počítání a skupiny · Další: Rozdělení do skupin
Zdrojový Python soubor
Rozdělení do skupin
Spusť soubor a porovnej výsledky.
prinesou = [("Anna", "dort"), ("Petra", "víno"), ("Jana", "chlebíčky"),
            ("Eva", "víno"), ("Marie", "dort")]
Kdo přinese který dárek? Klíč je dárek a hodnota seznam jmen. Seznam
pro dárek založíš, když na dárek narazíš poprvé. Pak do něj přidáváš:
podle_darku = {}

for jmeno, darek in prinesou:
    if darek not in podle_darku:
        podle_darku[darek] = []
    podle_darku[darek].append(jmeno)

print(podle_darku)
{'dort': ['Anna', 'Marie'], 'víno': ['Petra', 'Eva'], 'chlebíčky': ['Jana']}
Řádek s append čti po krocích. Dělá totéž co tyhle dva řádky:
jmena = podle_darku[darek]      seznam, který patří k dárku
jmena.append(jmeno)             přidá do něj jméno
Seznam ve slovníku se tím změní. Proměnná jmena a podle_darku[darek]
jsou dvě jména pro jeden seznam, jako v lekci 8.
Skupiny pak projdeš jako každý slovník. Seznam jmen spojíš metodou join:
for darek, jmena in podle_darku.items():
    print(f"{darek}: {', '.join(jmena)}")
dort: Anna, Marie
víno: Petra, Eva
chlebíčky: Jana
Klíčem může být i n-tice. Tak rozdělíš hosty podle dvou věcí najednou,
třeba podle stolu a nápoje:
hoste = [("Anna", 1, "víno"), ("Petra", 1, "džus"), ("Jana", 2, "víno"),
         ("Eva", 1, "víno")]

skupiny = {}

for jmeno, stul, napoj in hoste:
    klic = (stul, napoj)
    if klic not in skupiny:
        skupiny[klic] = []
    skupiny[klic].append(jmeno)

print(skupiny)
{(1, 'víno'): ['Anna', 'Eva'], (1, 'džus'): ['Petra'], (2, 'víno'): ['Jana']}
print(skupiny[(1, "víno")]) # ['Anna', 'Eva']
Seznam klíčem být nemůže, protože se dá měnit. Python by spadl
s hláškou TypeError: unhashable type: 'list'. N-tice se měnit nedá
(lekce 8), proto klíčem být může.
Zpět na téma: Počítání a skupiny · Další: Cvičení: Počítání a skupiny
Zdrojový Python soubor
Cvičení: Počítání a skupiny
Každé cvičení má vlastní soubor ve složce lekce09-slovniky/02_pocitani_a_skupiny/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Cvičení 1
Soubor: cviceni/01_hlasovani.py
Hosté vybírají dezert. Ptej se "Hlas: ", dokud někdo nenapíše "konec".
-
Hlasy počítej ve slovníku.
-
Velikost písmen a mezery navíc nehrají roli.
-
Prázdný hlas nepočítej.
-
Napiš funkci najdi_viteze, která má na vstupu slovník s hlasy
a vrátí dezert s nejvíc hlasy. Když nikdo nehlasoval, vrátí None.
-
Na konci vypiš počet hlasů pro každý dezert a vítěze. Když nikdo
nehlasoval, vypiš "Nikdo nehlasoval.".
Hlas: dort
Hlas: Zmrzlina
Hlas: dort
Hlas: konec
dort: 2
zmrzlina: 1
Vyhrává dort.
Zobrazit řešeníSkrýt řešení
def najdi_viteze(hlasy):
    vitez = None
    nejvic = 0
    for dezert, pocet in hlasy.items():
        if pocet > nejvic:
            vitez = dezert
            nejvic = pocet
    return vitez

hlasy = {}

while True:
    hlas = input("Hlas: ").strip().lower()
    if hlas == "konec":
        break
    if hlas == "":
        continue

    if hlas in hlasy:
        hlasy[hlas] = hlasy[hlas] + 1
    else:
        hlasy[hlas] = 1

for dezert, pocet in hlasy.items():
    print(f"{dezert}: {pocet}")

vitez = najdi_viteze(hlasy)
if vitez is None:
    print("Nikdo nehlasoval.")
else:
    print(f"Vyhrává {vitez}.")
Když je slovník prázdný, cyklus ve funkci neproběhne ani jednou
a vitez zůstane None. Zápis is None znáš z první sekce.
Cvičení 2
Soubor: cviceni/02_slova_ve_zprave.py
Napiš funkci spocitej_slova, která má na vstupu text a vrátí slovník:
klíč je slovo a hodnota říká, kolikrát v textu je. Velikost písmen
nehraje roli.
Pak vypiš jen slova, která jsou ve zprávě víc než jednou.
kdo: 3
přinese: 2
a: 2
zprava = "Kdo přinese víno a kdo přinese dort a kdo přijde pozdě"
Zobrazit řešeníSkrýt řešení
zprava = "Kdo přinese víno a kdo přinese dort a kdo přijde pozdě"

def spocitej_slova(text):
    pocty = {}
    for slovo in text.lower().split():
        if slovo in pocty:
            pocty[slovo] = pocty[slovo] + 1
        else:
            pocty[slovo] = 1
    return pocty

pocty = spocitej_slova(zprava)

for slovo, pocet in pocty.items():
    if pocet > 1:
        print(f"{slovo}: {pocet}")
Podmínku ve funkci jde zkrátit metodou get:
pocty[slovo] = pocty.get(slovo, 0) + 1
Pro prázdný text vrátí funkce prázdný slovník:
print(spocitej_slova("")) # {}
Cvičení 3
Soubor: cviceni/03_kostky.py
Hoď kostkou 600krát a spočítej, kolikrát padlo které číslo.
-
Slovník si připrav předem: klíče 1 až 6, hodnoty 0. Tak v něm budou
všechna čísla, a to ve správném pořadí.
-
Vypiš každé číslo s řadou hvězdiček. Jedna hvězdička znamená 10 hodů.
1: ********* (97)
2: ********** (104)
...
Na první řádek patří: from random import randrange
randrange(1, 7) vrátí náhodné číslo od 1 do 6.
Zobrazit řešeníSkrýt řešení
from random import randrange
pocty = {}
for cislo in range(1, 7):
    pocty[cislo] = 0

for hod in range(600):
    cislo = randrange(1, 7)
    pocty[cislo] = pocty[cislo] + 1

for cislo, pocet in pocty.items():
    hvezdicky = "*" * (pocet // 10)
    print(f"{cislo}: {hvezdicky} ({pocet})")
Cvičení 4
Soubor: cviceni/04_podle_pismene.py
Napiš funkci rozdel_podle_pismene, která má na vstupu seznam jmen
a vrátí slovník: klíč je první písmeno a hodnota seznam jmen, která
jím začínají.
Pak vypiš každé písmeno a za ním jména oddělená čárkou.
A: Anna, Adéla
P: Petra, Pavla
J: Jana
hoste = ["Anna", "Petra", "Jana", "Adéla", "Pavla"]
Zobrazit řešeníSkrýt řešení
hoste = ["Anna", "Petra", "Jana", "Adéla", "Pavla"]

def rozdel_podle_pismene(jmena):
    skupiny = {}
    for jmeno in jmena:
        pismeno = jmeno[0]
        if pismeno not in skupiny:
            skupiny[pismeno] = []
        skupiny[pismeno].append(jmeno)
    return skupiny

podle_pismene = rozdel_podle_pismene(hoste)

for pismeno, jmena in podle_pismene.items():
    print(f"{pismeno}: {', '.join(jmena)}")
Funkce počítá s tím, že žádné jméno není prázdný text. U prázdného
textu by jmeno[0] spadlo na IndexError.
Cvičení 5
Soubor: cviceni/05_zmizele_objednavky.py
Spusť soubor (Run). Výsledek je špatný. Najdi chybu debuggerem.
Program má spočítat, kolikrát si hosté objednali který nápoj. Vypíše
ale jen {'pivo': 1}. Dej breakpoint na řádek s if a krokuj. V panelu
Variables sleduj napoj a pocty. Pak program oprav.
Vyjít má: {'víno': 1, 'pivo': 3, 'džus': 1}
objednavky = ["víno", "pivo", "džus", "pivo", "pivo"]

for napoj in objednavky:
    pocty = {}
    if napoj in pocty:
        pocty[napoj] = pocty[napoj] + 1
    else:
        pocty[napoj] = 1

print(pocty)
Zobrazit řešeníSkrýt řešení
objednavky = ["víno", "pivo", "džus", "pivo", "pivo"]

pocty = {}
for napoj in objednavky:
    if napoj in pocty:
        pocty[napoj] = pocty[napoj] + 1
    else:
        pocty[napoj] = 1

print(pocty)
Řádek pocty = {} byl uvnitř cyklu. V každém průchodu tak vznikl nový
prázdný slovník a do něj se zapsal jen aktuální nápoj. Prázdný slovník
se musí založit jednou, před cyklem.
Cvičení 6
Soubor: cviceni/06_utrata_hostu.py
Jsou tu tři chyby a každá je jiného druhu. Jednu ti ukáže chybová
hláška, další dvě najdeš debuggerem. Oprav je po jedné a po každé
opravě program spusť.
Barman si zapisoval, kdo si co objednal. Píše, jak ho napadne, takže
víno může být i "Víno". Program má spočítat útratu každého hosta
a najít, kdo utratil nejvíc. Vypsat má:
Anna: 105 Kč
Petra: 120 Kč
Jana: 35 Kč
Nejvíc utratila Petra (120 Kč).
cenik = {"pivo": 45, "víno": 60, "džus": 35}
objednavky = [("Anna", "pivo"), ("Petra", "víno"), ("Anna", "Víno"),
              ("Jana", "džus"), ("Petra", "víno")]

def spocitej_utraty(objednavky, cenik):
    utraty = {}
    for jmeno, napoj in objednavky:
        cena = cenik[napoj]
        if jmeno in utraty:
            utraty[jmeno] = cena
        else:
            utraty[jmeno] = cena
    return utraty

def kdo_nejvic(utraty):
    kdo = ""
    nejvic = 0
    for jmeno, castka in utraty.items():
        if castka > nejvic:
            kdo = jmeno
    return kdo, nejvic

utraty = spocitej_utraty(objednavky, cenik)

for jmeno, castka in utraty.items():
    print(f"{jmeno}: {castka} Kč")

kdo, castka = kdo_nejvic(utraty)
print(f"Nejvíc utratila {kdo} ({castka} Kč).")
Zobrazit řešeníSkrýt řešení
cenik = {"pivo": 45, "víno": 60, "džus": 35}
objednavky = [("Anna", "pivo"), ("Petra", "víno"), ("Anna", "Víno"),
              ("Jana", "džus"), ("Petra", "víno")]

def spocitej_utraty(objednavky, cenik):
    utraty = {}
    for jmeno, napoj in objednavky:
        cena = cenik[napoj.lower()]                 # 1. chyba
        if jmeno in utraty:
            utraty[jmeno] = utraty[jmeno] + cena    # 2. chyba
        else:
            utraty[jmeno] = cena
    return utraty

def kdo_nejvic(utraty):
    kdo = ""
    nejvic = 0
    for jmeno, castka in utraty.items():
        if castka > nejvic:
            kdo = jmeno
            nejvic = castka                         # 3. chyba
    return kdo, nejvic

utraty = spocitej_utraty(objednavky, cenik)

for jmeno, castka in utraty.items():
    print(f"{jmeno}: {castka} Kč")

kdo, castka = kdo_nejvic(utraty)
print(f"Nejvíc utratila {kdo} ({castka} Kč).")
-
KeyError: 'Víno' – v ceníku jsou nápoje malými písmeny. Ukázala ji
chybová hláška.
-
Když host už ve slovníku byl, jeho útrata se přepsala cenou
posledního nápoje místo toho, aby se k ní přičetla. V debuggeru je
vidět, že Anně se z 45 stane 60.
-
Proměnná nejvic zůstávala na nule, takže podmínku splnil každý host
a vyhrál ten poslední. V debuggeru je vidět, že nejvic se nemění.
Zpět na téma: Počítání a skupiny · Další: Bonusová cvičení: Počítání a skupiny
Zdrojové soubory na GitHubu
Bonusová cvičení: Počítání a skupiny
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce09-slovniky/02_pocitani_a_skupiny/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Bonus 1
Soubor: cviceni_bonusy/01_anagramy.py
Anagramy jsou slova ze stejných písmen, jen jinak poskládaných, třeba
"rak" a "kra". Rozděl slova do skupin anagramů a vypiš skupiny,
ve kterých je víc než jedno slovo.
Tip: dvě slova jsou anagramy, když mají po seřazení písmen stejný
text. Slovo převedeš na seznam písmen funkcí list (lekce 8), seznam
seřadíš metodou sort a zpátky spojíš metodou join.
rak, kra
kos, sok
loket, kotel
lak, kal
slova = ["rak", "kos", "loket", "kra", "les", "sok", "kotel", "lak", "kal"]
Zobrazit řešeníSkrýt řešení
slova = ["rak", "kos", "loket", "kra", "les", "sok", "kotel", "lak", "kal"]

def serazena_pismena(slovo):
    pismena = list(slovo)
    pismena.sort()
    return "".join(pismena)

skupiny = {}
for slovo in slova:
    klic = serazena_pismena(slovo)
    if klic not in skupiny:
        skupiny[klic] = []
    skupiny[klic].append(slovo)

for slova_ve_skupine in skupiny.values():
    if len(slova_ve_skupine) > 1:
        print(", ".join(slova_ve_skupine))
Bonus 2
Soubor: cviceni_bonusy/02_turnaj.py
Na večírku se hraje turnaj v ping-pongu. Každý zápas je dvojice
(vítěz, poražený). Spočítej, kolik zápasů kdo vyhrál. Ve výsledku
musí být každý hráč, i ten, kdo nevyhrál nic.
Anna: 2
Petra: 1
Jana: 0
zapasy = [("Anna", "Petra"), ("Petra", "Jana"), ("Anna", "Jana")]
Zobrazit řešeníSkrýt řešení
zapasy = [("Anna", "Petra"), ("Petra", "Jana"), ("Anna", "Jana")]

vyhry = {}
for vitez, porazeny in zapasy:
    if vitez in vyhry:
        vyhry[vitez] = vyhry[vitez] + 1
    else:
        vyhry[vitez] = 1
    if porazeny not in vyhry:
        vyhry[porazeny] = 0

for hrac, pocet in vyhry.items():
    print(f"{hrac}: {pocet}")
Zpět na téma: Počítání a skupiny
Zdrojové soubory na GitHubu
Záznamy
Procházej příklady postupně, pak si vyzkoušej cvičení. Kód z bloků si můžeš zkopírovat do Python souboru ve VS Code a spustit. Příklady na jedné stránce na sebe mohou navazovat.
Zpět na přehled hodiny
Slovník jako záznam
Spusť soubor a porovnej výsledky.
V lekci 8 jsi o hostovi držela víc údajů v n-tici:
anna = ("Anna", 34, "dort")
print(anna[1])          # 34
Co je 34? Musíš si pamatovat, že na indexu 1 je věk.
Slovník může držet údaje o jedné věci. Klíče jsou názvy údajů, takže
je hned vidět, co je co:
anna = {"jmeno": "Anna", "vek": 34, "darek": "dort"}

print(anna["vek"])      # 34
print(f"{anna['jmeno']} přinese {anna['darek']}.")     # Anna přinese dort.
V lekci 8 jsme si řekli, že míchat v seznamu různé druhy hodnot nebývá
dobrý nápad. V záznamu je to naopak běžné: text, číslo, cokoli. Každý
klíč má svůj vlastní údaj, takže víš, co pod ním najdeš.
Údaj přidáš nebo změníš jako u každého slovníku:
anna["telefon"] = "602 111 222"
anna["darek"] = "koláč"
print(anna)
{'jmeno': 'Anna', 'vek': 34, 'darek': 'koláč', 'telefon': '602 111 222'}
Takhle může vypadat i výsledek funkce. V lekci 8 vracela funkce
n-tici a ty sis musela pamatovat pořadí. Ve slovníku má každá hodnota
jméno.
Dlouhý slovník se dá rozepsat na víc řádků, jako seznam s kvízem
v lekci 8. Každá dvojice na vlastním řádku se líp čte.
def statistika(veky):
    if len(veky) == 0:
        return {"pocet": 0, "prumer": None, "nejstarsi": None}

    return {
        "pocet": len(veky),
        "prumer": sum(veky) / len(veky),
        "nejstarsi": max(veky),
    }

vysledek = statistika([34, 25, 41])
print(f"{vysledek['prumer']:.1f}")     # 33.3
print(vysledek["nejstarsi"])    # 41

print(statistika([]))   # {'pocet': 0, 'prumer': None, 'nejstarsi': None}
Prázdný seznam se kontroluje jako první. Jinak by funkce spadla
na dělení nulou.
Zpět na téma: Záznamy · Další: Seznam slovníků: tabulka
Zdrojový Python soubor
Seznam slovníků: tabulka
Spusť soubor a porovnej výsledky.
Hostů je víc, takže záznamy dáš do seznamu. Každý slovník je jeden host
a všechny mají stejné klíče:
hoste = [
    {"jmeno": "Anna", "vek": 34, "darek": "dort"},
    {"jmeno": "Petra", "vek": 25, "darek": "víno"},
    {"jmeno": "Jana", "vek": 41, "darek": "víno"},
]
Je to vlastně tabulka. Položky seznamu jsou řádky, klíče sloupce:
jmeno vek darek
Anna 34 dort
Petra 25 víno
Jana 41 víno
Jeden údaj přečteš ve dvou krocích. Nejdřív vezmeš hosta ze seznamu,
pak údaj ze slovníku:
prvni = hoste[0]
print(prvni["jmeno"])           # Anna
Oba kroky jde napsat za sebe. Čte se to zleva doprava:
print(hoste[0]["jmeno"]) # Anna
Kratší ale neznamená lepší. Když se ti to líp čte ve dvou krocích,
piš to ve dvou krocích.
V cyklu dostaneš po jednom celé záznamy:
for host in hoste:
    print(f"{host['jmeno']:6} {host['vek']:3}   {host['darek']}")
Anna 34 dort
Petra 25 víno
Jana 41 víno
Se záznamy funguje všechno, co už znáš. Kdo přinese víno:
vino = []
for host in hoste:
    if host["darek"] == "víno":
        vino.append(host["jmeno"])

print(vino)                     # ['Petra', 'Jana']
Průměrný věk:
soucet = 0
for host in hoste:
    soucet = soucet + host["vek"]

print(f"Průměrný věk: {soucet / len(hoste):.1f}")      # Průměrný věk: 33.3
Přesně takhle vypadají data z tabulky v souboru CSV. Každý řádek se
načte jako jeden slovník. Na workshopu a v lekci 13 to uvidíš naživo.
Zpět na téma: Záznamy · Další: Data v datech
Zdrojový Python soubor
Data v datech
Spusť soubor a porovnej výsledky.
Seznam jako hodnotu ve slovníku znáš ze skupin v minulé sekci. Hodnotou
může být i další slovník. Nové je tu čtení o dvě úrovně hluboko. Celý
večírek v jedné proměnné:
vecirek = {
    "datum": "21. 11.",
    "hoste": ["Anna", "Petra", "Jana"],
    "rozpocet": {"jidlo": 1500, "piti": 800},
}
Čte se to po krocích, stejně jako seznam slovníků. Pod klíčem "hoste"
je seznam:
hoste = vecirek["hoste"]
print(hoste)                    # ['Anna', 'Petra', 'Jana']
print(hoste[0])                 # Anna
Za sebou:
print(vecirek["hoste"][0]) # Anna
Pod klíčem "rozpocet" je další slovník:
rozpocet = vecirek["rozpocet"]
print(rozpocet["piti"])         # 800
Za sebou:
print(vecirek["rozpocet"]["piti"]) # 800
Zápis za sebou je kratší, s mezikrokem přehlednější. Vyber si, co se
ti líp čte.
Když si nejsi jistá, co je pod klíčem schované, vypiš to. Hranaté
závorky ve výpisu znamenají seznam, složené slovník.
Měnit se to dá stejně. Přišla Eva a na pití se přidává 200 Kč:
vecirek["hoste"].append("Eva")
vecirek["rozpocet"]["piti"] = vecirek["rozpocet"]["piti"] + 200

print(vecirek["hoste"])         # ['Anna', 'Petra', 'Jana', 'Eva']
print(vecirek["rozpocet"])      # {'jidlo': 1500, 'piti': 1000}
Celkový rozpočet sečteš přes hodnoty vnitřního slovníku:
print(sum(vecirek["rozpocet"].values())) # 2500
Data z webových služeb a ze souborů JSON vypadají přesně takhle:
slovníky a seznamy v sobě. Potkáš je na workshopu.
Zpět na téma: Záznamy · Další: Slovník ve funkci a kopie
Zdrojový Python soubor
Slovník ve funkci a kopie
Spusť soubor a porovnej výsledky.
Se slovníkem je to stejné jako se seznamem v lekci 8. Funkce dostane
ten samý slovník, a když ho změní, je to vidět i venku:
def pridej_skupinu(host):
    if host["vek"] < 18:
        host["skupina"] = "dítě"
    else:
        host["skupina"] = "dospělý"

anna = {"jmeno": "Anna", "vek": 34}
pridej_skupinu(anna)
print(anna)     # {'jmeno': 'Anna', 'vek': 34, 'skupina': 'dospělý'}
Funkce nic nevrací, a přesto se slovník změnil. Někdy je to přesně to,
co chceš. Funkce pak upraví všechny záznamy v seznamu jedním cyklem:
hoste = [{"jmeno": "Petra", "vek": 25}, {"jmeno": "Tom", "vek": 9}]

for host in hoste:
    pridej_skupinu(host)

print(hoste)
[{'jmeno': 'Petra', 'vek': 25, 'skupina': 'dospělý'},
{'jmeno': 'Tom', 'vek': 9, 'skupina': 'dítě'}]
Pozor na to i mimo funkce. Přiřazení slovník nezkopíruje, obě proměnné
pak ukazují na jeden slovník:
jana = {"jmeno": "Jana", "vek": 41}
druha = jana
druha["vek"] = 99
print(jana["vek"])          # 99
Když původní slovník změnit nechceš, udělej si kopii metodou copy.
Funguje stejně jako u seznamů v lekci 8 (soubor 07_dve_jmena.py):
def s_kontaktem(host, telefon):
    novy = host.copy()
    novy["telefon"] = telefon
    return novy

jana = {"jmeno": "Jana", "vek": 41}
jana_s_kontaktem = s_kontaktem(jana, "608 999 000")

print(jana_s_kontaktem)     # {'jmeno': 'Jana', 'vek': 41, 'telefon': '608 999 000'}
print(jana)                 # {'jmeno': 'Jana', 'vek': 41}
Shrnutí celé lekce. Slovník se hodí na tři věci:
hledání podle klíče ceník, telefonní seznam, překlady
počítání a skupiny hlasy pro písničky, kdo přinese co
záznam o jedné věci host se jménem, věkem a dárkem
Seznam slovníků je pak celá tabulka. Přesně s těmihle třemi postupy
budeš pracovat na sobotním workshopu.
Zpět na téma: Záznamy · Další: Cvičení: Záznamy
Zdrojový Python soubor
Cvičení: Záznamy
Každé cvičení má vlastní soubor ve složce lekce09-slovniky/03_zaznamy/cviceni/. Otevři ho ve VS Code, doplň kód pod zadání a soubor spusť (Run). Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Cvičení 1
Soubor: cviceni/01_vizitka.py
Vytvoř slovník o sobě s klíči jmeno, mesto a oblibene_jidlo. Pak:
-
vypiš z něj dvě věty, třeba:
Jmenuju se Anna a bydlím ve městě Brno.
Nejradši jím knedlíky.
-
přidej klíč konicky a jako hodnotu mu dej seznam tří koníčků,
-
vypiš každý koníček na vlastní řádek s pomlčkou na začátku.
Zobrazit řešeníSkrýt řešení
ja = {"jmeno": "Anna", "mesto": "Brno", "oblibene_jidlo": "knedlíky"}

print(f"Jmenuju se {ja['jmeno']} a bydlím ve městě {ja['mesto']}.")
print(f"Nejradši jím {ja['oblibene_jidlo']}.")

ja["konicky"] = ["lezení", "šachy", "Python"]

for konicek in ja["konicky"]:
    print(f"- {konicek}")
Cvičení 2
Soubor: cviceni/02_filmovy_vecer.py
Na filmový večer hosté obodovali filmy od 1 do 10. Napiš tři funkce,
které mají na vstupu seznam filmů:
-
filmy_od_roku má na vstupu ještě rok a vrátí seznam názvů filmů
natočených v tom roce nebo později,
-
prumer_bodu vrátí průměrný počet bodů,
-
nejlepsi_film vrátí celý záznam filmu s nejvíc body.
Když je seznam prázdný, vrátí prumer_bodu a nejlepsi_film None.
Pak pomocí funkcí vypiš:
Od roku 2000: Kytice, Tmavomodrý svět, Samotáři
Průměr: 7.5
Nejlepší: Pelíšky (9 bodů)
filmy = [
    {"nazev": "Vesničko má středisková", "rok": 1985, "body": 8},
    {"nazev": "Kytice", "rok": 2000, "body": 6},
    {"nazev": "Tmavomodrý svět", "rok": 2001, "body": 7},
    {"nazev": "Pelíšky", "rok": 1999, "body": 9},
    {"nazev": "Samotáři", "rok": 2000, "body": 8},
    {"nazev": "Obecná škola", "rok": 1991, "body": 7},
]
Zobrazit řešeníSkrýt řešení
filmy = [
    {"nazev": "Vesničko má středisková", "rok": 1985, "body": 8},
    {"nazev": "Kytice", "rok": 2000, "body": 6},
    {"nazev": "Tmavomodrý svět", "rok": 2001, "body": 7},
    {"nazev": "Pelíšky", "rok": 1999, "body": 9},
    {"nazev": "Samotáři", "rok": 2000, "body": 8},
    {"nazev": "Obecná škola", "rok": 1991, "body": 7},
]

def filmy_od_roku(filmy, rok):
    nazvy = []
    for film in filmy:
        if film["rok"] >= rok:
            nazvy.append(film["nazev"])
    return nazvy

def prumer_bodu(filmy):
    if len(filmy) == 0:
        return None

    soucet = 0
    for film in filmy:
        soucet = soucet + film["body"]
    return soucet / len(filmy)

def nejlepsi_film(filmy):
    if len(filmy) == 0:
        return None

    nejlepsi = filmy[0]
    for film in filmy:
        if film["body"] > nejlepsi["body"]:
            nejlepsi = film
    return nejlepsi

print(f"Od roku 2000: {', '.join(filmy_od_roku(filmy, 2000))}")
print(f"Průměr: {prumer_bodu(filmy):.1f}")

nejlepsi = nejlepsi_film(filmy)
print(f"Nejlepší: {nejlepsi['nazev']} ({nejlepsi['body']} bodů)")
U nejlepšího filmu si stačí pamatovat celý záznam. Název i body
z něj pak přečteš.
Kontrola prázdného seznamu je ve funkcích první. Bez ní by průměr
spadl na dělení nulou a filmy[0] na IndexError.
Cvičení 3
Soubor: cviceni/03_ukoly_na_vecirek.py
Na večírek je potřeba spoustu věcí zařídit. Vypiš:
Hotovo: 2 z 5
Anna: upéct dort
Petra: nafouknout balonky, připravit playlist
ukoly = [
    {"ukol": "koupit víno", "kdo": "Petra", "hotovo": True},
    {"ukol": "upéct dort", "kdo": "Anna", "hotovo": False},
    {"ukol": "nafouknout balonky", "kdo": "Petra", "hotovo": False},
    {"ukol": "poslat pozvánky", "kdo": "Jana", "hotovo": True},
    {"ukol": "připravit playlist", "kdo": "Petra", "hotovo": False},
]
Zobrazit řešeníSkrýt řešení
ukoly = [
    {"ukol": "koupit víno", "kdo": "Petra", "hotovo": True},
    {"ukol": "upéct dort", "kdo": "Anna", "hotovo": False},
    {"ukol": "nafouknout balonky", "kdo": "Petra", "hotovo": False},
    {"ukol": "poslat pozvánky", "kdo": "Jana", "hotovo": True},
    {"ukol": "připravit playlist", "kdo": "Petra", "hotovo": False},
]

hotovych = 0
zbyva = {}

for ukol in ukoly:
    if ukol["hotovo"]:
        hotovych = hotovych + 1
    else:
        kdo = ukol["kdo"]
        if kdo not in zbyva:
            zbyva[kdo] = []
        zbyva[kdo].append(ukol["ukol"])

print(f"Hotovo: {hotovych} z {len(ukoly)}")

for kdo, jeho_ukoly in zbyva.items():
    print(f"{kdo}: {', '.join(jeho_ukoly)}")
Cvičení 4
Soubor: cviceni/04_oprav_kontakty.py
Oprav kód a soubor spusť (Run).
Program má vypsat telefon každého hosta. Petra ale telefon nenechala
a program na ní spadne. Spusť ho, přečti si hlášku a oprav ho tak,
aby u Petry vypsal "neuvedeno".
Anna: 602 111 222
Petra: neuvedeno
Jana: 608 999 000
hoste = [
    {"jmeno": "Anna", "telefon": "602 111 222"},
    {"jmeno": "Petra"},
    {"jmeno": "Jana", "telefon": "608 999 000"},
]

for host in hoste:
    print(f"{host['jmeno']}: {host['telefon']}")
Zobrazit řešeníSkrýt řešení
hoste = [
    {"jmeno": "Anna", "telefon": "602 111 222"},
    {"jmeno": "Petra"},
    {"jmeno": "Jana", "telefon": "608 999 000"},
]

for host in hoste:
    telefon = host.get("telefon", "neuvedeno")
    print(f"{host['jmeno']}: {telefon}")
Hláška KeyError: 'telefon' říká, že v jednom záznamu klíč chybí.
Metoda get vrátí místo chyby výchozí hodnotu.
Cvičení 5
Soubor: cviceni/05_rozpocet.py
Plánovala jsi, kolik utratíš za večírek, a teď víš, kolik jsi
opravdu utratila. U každé položky vypiš, o kolik jsi plán překročila
nebo kolik ušetřila. Na konci vypiš, kolik jsi utratila celkem
a kolik jsi plánovala.
jídlo: přes plán o 220 Kč
pití: ušetřeno 150 Kč
výzdoba: přesně podle plánu
Celkem utraceno 2670 Kč z plánovaných 2600 Kč.
rozpocet = {
    "jídlo": {"plan": 1500, "utraceno": 1720},
    "pití": {"plan": 800, "utraceno": 650},
    "výzdoba": {"plan": 300, "utraceno": 300},
}
Zobrazit řešeníSkrýt řešení
rozpocet = {
    "jídlo": {"plan": 1500, "utraceno": 1720},
    "pití": {"plan": 800, "utraceno": 650},
    "výzdoba": {"plan": 300, "utraceno": 300},
}

celkem_plan = 0
celkem_utraceno = 0

for polozka, castky in rozpocet.items():
    plan = castky["plan"]
    utraceno = castky["utraceno"]
    celkem_plan = celkem_plan + plan
    celkem_utraceno = celkem_utraceno + utraceno

    if utraceno > plan:
        print(f"{polozka}: přes plán o {utraceno - plan} Kč")
    elif utraceno < plan:
        print(f"{polozka}: ušetřeno {plan - utraceno} Kč")
    else:
        print(f"{polozka}: přesně podle plánu")

print(f"Celkem utraceno {celkem_utraceno} Kč z plánovaných {celkem_plan} Kč.")
Cvičení 6
Soubor: cviceni/06_vstupenky.py
Jsou tu tři chyby a každá je jiného druhu. Jednu ti ukáže chybová
hláška, další dvě najdeš debuggerem. Oprav je po jedné a po každé
opravě program spusť.
Program prodává vstupenky na večírek. Děti do 15 let platí 100 Kč,
ostatní 250 Kč. Funkce s_cenou má vrátit kopii hosta s cenou, původní
seznam hostů se nemá změnit. Vypsat má:
Anna: 250 Kč
Tom: 100 Kč
Petra: 250 Kč
Ema: 100 Kč
Celkem: 700 Kč
Původní záznam: {'jmeno': 'Anna', 'vek': 34}
hoste = [
    {"jmeno": "Anna", "vek": 34},
    {"jmeno": "Tom", "vek": 9},
    {"jmeno": "Petra", "vek": 25},
    {"jmeno": "Ema", "vek": 12},
]

def s_cenou(host):
    novy = host
    if host["vek"] < 15:
        novy["cena"] = 100
    else:
        novy["cena"] = 250
    return novy

def celkem(vstupenky):
    soucet = 0
    for vstupenka in vstupenky:
        soucet = soucet + vstupenka["cena"]
        return soucet

vstupenky = []
for host in hoste:
    vstupenky.append(s_cenou(host))

for vstupenka in vstupenky:
    print(f"{vstupenka['jmneo']}: {vstupenka['cena']} Kč")

print(f"Celkem: {celkem(vstupenky)} Kč")
print(f"Původní záznam: {hoste[0]}")
Zobrazit řešeníSkrýt řešení
hoste = [
    {"jmeno": "Anna", "vek": 34},
    {"jmeno": "Tom", "vek": 9},
    {"jmeno": "Petra", "vek": 25},
    {"jmeno": "Ema", "vek": 12},
]

def s_cenou(host):
    novy = host.copy()                  # 2. chyba
    if host["vek"] < 15:
        novy["cena"] = 100
    else:
        novy["cena"] = 250
    return novy

def celkem(vstupenky):
    soucet = 0
    for vstupenka in vstupenky:
        soucet = soucet + vstupenka["cena"]
    return soucet                       # 3. chyba

vstupenky = []
for host in hoste:
    vstupenky.append(s_cenou(host))

for vstupenka in vstupenky:
    print(f"{vstupenka['jmeno']}: {vstupenka['cena']} Kč")     # 1. chyba

print(f"Celkem: {celkem(vstupenky)} Kč")
print(f"Původní záznam: {hoste[0]}")
-
KeyError: 'jmneo' – překlep v klíči. Ukázala ji chybová hláška.
-
Bez copy byl novy jen druhé jméno pro původní slovník, takže cena
se zapsala i do seznamu hostů. V debuggeru je vidět, že po prvním
volání má cenu i hoste[0].
-
Return byl odsazený uvnitř cyklu, takže funkce skončila po první
vstupence a vrátila 250. Krokováním je vidět, že cyklus proběhne
jen jednou.
Zpět na téma: Záznamy · Další: Bonusová cvičení: Záznamy
Zdrojové soubory na GitHubu
Bonusová cvičení: Záznamy
Bonusy jsou pro rychlíky – když máš hotová cvičení a zbývá čas. Každý bonus má vlastní soubor ve složce lekce09-slovniky/03_zaznamy/cviceni_bonusy/. Řešení si rozklikni až po vlastním pokusu – tvoje řešení může vypadat jinak, a to je v pořádku.
Bonus 1
Soubor: cviceni_bonusy/01_recept.py
Recept je na 4 porce. Zeptej se, pro kolik lidí vaříš, a vypiš
suroviny přepočítané na tolik porcí. Množství zaokrouhli na celé
číslo (funkce round z lekce 3).
Když uživatel nezadá kladné celé číslo, vypiš "Zadej kladné celé
číslo." a nic nepočítej.
Pro kolik lidí? 6
mouka: 750 g
mléko: 450 ml
vejce: 3 ks
cukr: 150 g
recept = {
    "porce": 4,
    "suroviny": {
        "mouka": (500, "g"),
        "mléko": (300, "ml"),
        "vejce": (2, "ks"),
        "cukr": (100, "g"),
    },
}
Zobrazit řešeníSkrýt řešení
recept = {
    "porce": 4,
    "suroviny": {
        "mouka": (500, "g"),
        "mléko": (300, "ml"),
        "vejce": (2, "ks"),
        "cukr": (100, "g"),
    },
}

odpoved = input("Pro kolik lidí? ").strip()

if not odpoved.isdigit() or int(odpoved) == 0:
    print("Zadej kladné celé číslo.")
else:
    pomer = int(odpoved) / recept["porce"]

    for surovina, udaj in recept["suroviny"].items():
        mnozstvi, jednotka = udaj
        print(f"{surovina}: {round(mnozstvi * pomer)} {jednotka}")
Metodu isdigit znáš z lekce 6. Text jako "šest" nebo "-2" neprojde,
takže se na něm int nespustí. Nulu je potřeba vyloučit zvlášť.
Bonus 2
Soubor: cviceni_bonusy/02_vyrovnani.py
Tři kamarádky platily za večírek každá něco. Náklady se mají rozdělit
rovným dílem.
-
Napiš funkci kolik_kdo_zaplatil, která má na vstupu seznam plateb
a vrátí slovník: jméno a kolik ta osoba zaplatila celkem.
-
Spočítej, kolik vychází na jednu.
-
Vypiš, kdo má kolik doplatit nebo dostat zpátky.
Anna zaplatila 510 Kč
Petra zaplatila 480 Kč
Jana zaplatila 360 Kč
Na jednu: 450 Kč
Anna dostane zpátky 60 Kč
Petra dostane zpátky 30 Kč
Jana doplatí 90 Kč
platby = [
    {"kdo": "Anna", "za_co": "dort", "castka": 420},
    {"kdo": "Petra", "za_co": "víno", "castka": 450},
    {"kdo": "Anna", "za_co": "balonky", "castka": 90},
    {"kdo": "Jana", "za_co": "chlebíčky", "castka": 360},
    {"kdo": "Petra", "za_co": "led", "castka": 30},
]
Zobrazit řešeníSkrýt řešení
platby = [
    {"kdo": "Anna", "za_co": "dort", "castka": 420},
    {"kdo": "Petra", "za_co": "víno", "castka": 450},
    {"kdo": "Anna", "za_co": "balonky", "castka": 90},
    {"kdo": "Jana", "za_co": "chlebíčky", "castka": 360},
    {"kdo": "Petra", "za_co": "led", "castka": 30},
]

def kolik_kdo_zaplatil(platby):
    zaplatila = {}
    for platba in platby:
        kdo = platba["kdo"]
        zaplatila[kdo] = zaplatila.get(kdo, 0) + platba["castka"]
    return zaplatila

zaplatila = kolik_kdo_zaplatil(platby)

if len(zaplatila) == 0:
    print("Nikdo nic neplatil.")
else:
    for kdo, castka in zaplatila.items():
        print(f"{kdo} zaplatila {castka} Kč")

    # Podíl se zaokrouhlí na celé koruny hned. Jinak by se porovnávaly
    # i haléře, které výpis nezobrazí, a mohlo by vyjít „doplatí 0 Kč“.
    na_jednu = round(sum(zaplatila.values()) / len(zaplatila))
    print(f"Na jednu: {na_jednu} Kč")

    for kdo, castka in zaplatila.items():
        rozdil = castka - na_jednu
        if rozdil > 0:
            print(f"{kdo} dostane zpátky {rozdil} Kč")
        elif rozdil < 0:
            print(f"{kdo} doplatí {-rozdil} Kč")
        else:
            print(f"{kdo} je vyrovnaná")
Zpět na téma: Záznamy
Zdrojové soubory na GitHubu